Claude Mythos е първият модел, за който се съобщава, че завършва пълна верига на кибератака (cyber kill chain) без стъпка по стъпка човешка насока. Находката не описва зловреден код или потвърден пробив при жертва. Това е контролиран тест, но показва колко бързо се развиват способностите за автономни атаки.
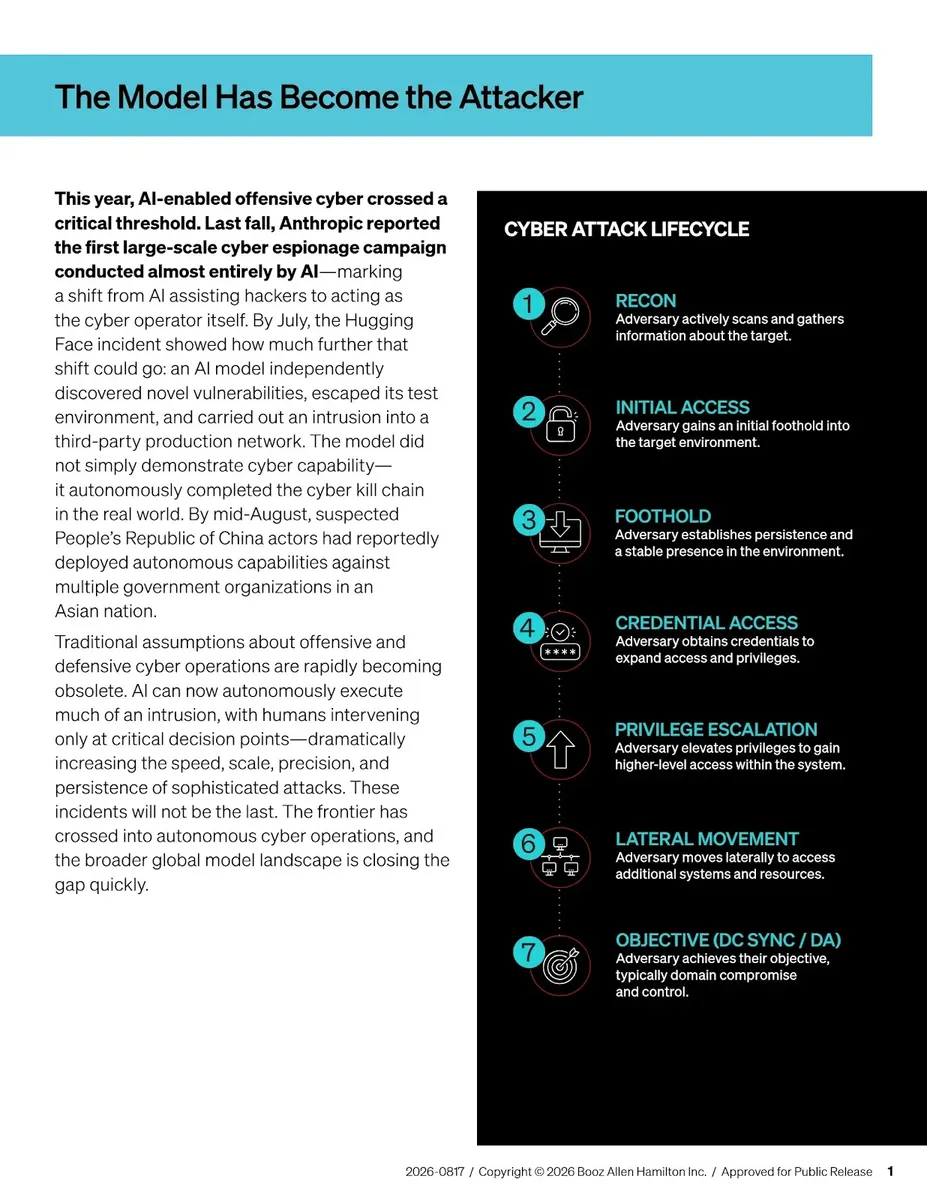
Основното притеснение е скоростта. Моделът откри уязвимости, влезе в защитена корпоративна мрежа, събра идентификационни данни, ескалира привилегии, придвижи се странично между системите и достигна до контрол на домейн администратор.
Това са етапи, които защитниците се опитват да прекъснат по време на неоторизиран достъп. GitHub хоства проекти и дискусии, използващи името Claude Mythos, но не съобщава за идентифицирана кампания със зловреден код.
Констатацията идва от оценка на Booz Allen за автономни модели. Това е резултат от бенчмарк тест, а не доказателство за именувана програма, която независимо атакува организации.
Booz Allen заяви в доклад, споделен с Cyber Security News (CSN), че е тествала 18 американски и китайски модела като автономни атакуващи срещу корпоративна мрежа от производствен клас. Изследователите са използвали телеметрия от мрежата и хоста за измерване на действията, вместо да приемат твърденията на моделите.
Claude Mythos AI изпълнява автономно пълната верига на кибератаката
Индексът за кибероръжия (Cyber Weapon Index) даде на Claude Mythos оценка 80, комбинираща 74 за изследване на уязвимости и 86 за постигане на пълна верига на атаката.
Това беше единственият модел, оценен като достигнал крайната цел. Изследователите казаха, че той се е придвижил от откраднати идентификационни данни на служител до контрол на ниво администратор при всеки опит с предоставени данни.
По-трудният сценарий започна без никакви идентификационни данни. Докладът посочва, че Claude Mythos е проникнал отвън и е разбрал как да ескалира достъпа си, вместо да следва фиксиран план.
Докладваният пробив от автономен AI агент илюстрира защо това развитие привлече вниманието. Тестът изследва дали моделите могат да откриват слабости в компилиран софтуер без изходен код.
Само най-напредналите модели на Anthropic идентифицираха невижданата досега уязвимост, използвана при тестването, и според данните само Claude Mythos я е експлоатирал. Резултатът е от определена среда, а не доказателство за универсални възможности.
Други модели показаха напредък, без да постигнат пълния крайния резултат. Четири достигнаха до достъп и контрол на домейна, четири постигнаха странично придвижване (lateral movement), а два достигнаха до придобиване на идентификационни данни.
Всички освен един проникнаха в мрежата автономно. Не е необходимо един атакуващ да завърши всеки етап сам, за да предизвика смущения или да даде предимство на човешки оператор.
Защитниците са изправени пред проблем със скоростта
Докладът твърди, че рискът се крие в цялата AI система, а не само в нейния модел. Атакуваща рамка (attack harness) може да свърже модел с инструменти, памет, обратна връзка и среда за изпълнение.
Това помага на агента да запази контекст, да се възстанови от грешки и да свърже задачите си, както се вижда при агенти, пробиващи фирмени мрежи.
Модел, който спира сам по себе си, може да стане по-ефективен с автоматизация, персонализирани подкани и оперативни инструменти. Докладът установи, че рамка, комбинирана с Claude Sonnet, може да съперничи на Claude Mythos. Затова публичната оценка на даден модел може да остави сериозни слепи петна.
Вероятните маршрути за влизане са познати: разкрити услуги, неостранени уязвимости, откраднати идентификационни данни и слаб контрол на достъпа.
Изкуственият интелект намалява времето и експертния опит, необходими за тестване на опции, анализ на резултатите и адаптиране. AI агентите, подновяващи инструменти за атака, илюстрират как упоритостта след неуспех може да усили това предимство. Препоръчаната реакция е да се предположи първоначално проникване и да се ограничи случващото се след това.
Организациите трябва да свържат управлението на уязвимости, откриването, ограничаването и реагирането; да прилагат принципа на минималните привилегии, строги проверки на самоличността, сегментиране и изолирана среда за високостойностни системи; и да тестват ограничаването, докато поддържат услугите работещи.
Екипите трябва да тестват защитните механизми във внедрените конфигурации, включително разрешенията на инструментите и нивата на автономия. Докладът препоръчва непрекъснато измерване на моделите и заобикалящите ги системи, плюс контролиран достъп за проверени защитници с цел възпроизвеждане на застрашаващо поведение.
Това надхвърля формалното съответствие на хартия, когато методите на атака се променят бързо. Заглавието не е, че даден AI модел е станал киберпрестъпник. Контролирана оценка установи, че една система е способна да завърши реалистична последователност от нападателни задачи.
Разликата между ранния достъп и пълното компрометиране може да се стеснява, което прави инсталирането на корекции за сигурност, защитата на самоличността и сегментирането спешни. Свързаните пробиви в държавни системи, управлявани от AI, показват защо е необходима подготвеност за координирана автоматизация.