В доклада на Gartner Validate the Promises of AI SOC Agents With These Key Questions анализаторите Крейг Лосън и Андрю Дейвис твърдят, че „До 2028 г. 70% от големите SOC центрове ще изпробват AI агенти за подпомагане на операциите от Ниво 1 и Ниво 2, но само 15% ще постигнат измерими подобрения без структурирана оценка.“
Само миналата година Gartner постави AI SOC агентите в етапа „Иновационен тласък“ (Innovation Trigger) с едноцифрено процентно приемане. В началото на тази година Hype Cycle for Security Operations, 2026 на Gartner ги постави на „Върха на раздутите очаквания“ (Peak of Inflated Expectations).
А според доклада State of AI in Security Operations 2026 на Prophet Security 40% от екипите за сигурност вече използват изкуствен интелект ежедневно, 56% в момента го оценяват или пилотират в своите среди, и само 4% нямат планове да го внедрят.
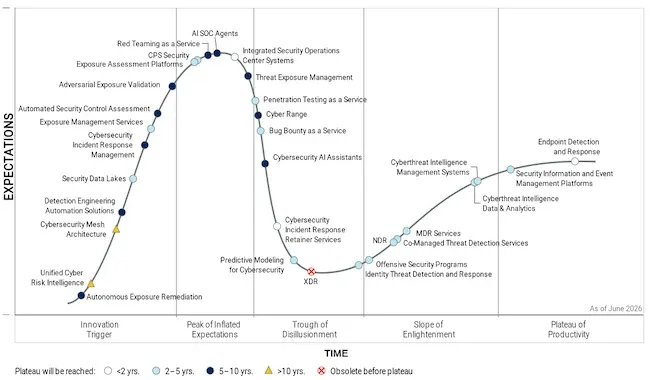
Hype cycle за операции по сигурност, 2026 (Източник: Gartner)
Налице е значителен инерционен устрем за AI в SOC центровете, но структурираната оценка е необходима, ако организациите очакват да превърнат това в реални резултати за своите програми за сигурност.
За тази цел Gartner предлага прагматичен набор от въпроси за оценка на AI SOC агентите, помагайки на специалистите по сигурност да разграничат жизнеспособните решения от широко разпространения днес на пазара „AI washing“ и да съгласуват внедряването с измерими оперативни резултати. Ето основните области, които Gartner препоръчва да се оценят, и как тази рамка се съпоставя с по-нови данни от проучвания.
Първият набор от въпроси от Gartner има за цел да започне от вашите тесни места, а не от списъка с функции на даден доставчик. Заслужава си да картографирате кои случаи на употреба значително биха намалили времето, прекарано в повтаряща се, монотонна работа, която може да бъде автоматизирана, вместо да се опитвате да въвеждате автоматизация заради самата автоматизация.
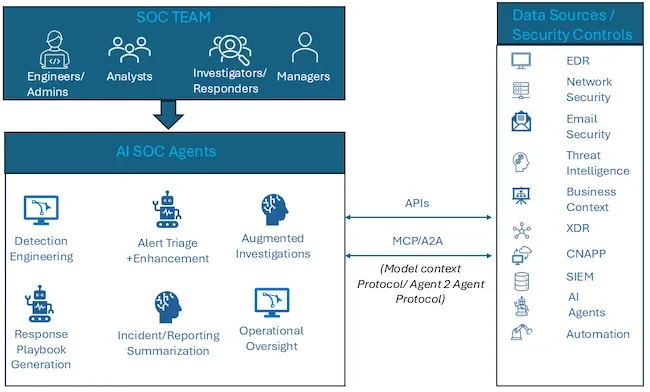
Използване на Al SOC агенти (Източник: Gartner)
Въпреки това си струва и да преоцените тесните места на вашата организация и предишните механизми за контрол, въведени за справяне с тях.
Данните от проучването последователно показват, че повечето екипи отговарят на този въпрос на фона на непълна картина на собственото си работно натоварване. В проучването от 2026 г. анкетираните съобщават, че 28% от сигнала за тревога (сигналите) никога не се разследват, а до 40% от организациите са изключили конкретни правила за откриване поради ограничения в капацитета.
Премахването на правило, което никога не е довело до ескалация, е добра инженерна практика за откриване на заплахи, но изключването на правило, защото неговият резултат е останал непрочетен, е решение за покритието, което обикновено има обратен ефект. Около 60% от анкетираните казват, че пропуснат или никога неразследван сигнал се е оказал съществен, а при 34% това се е случвало три или повече пъти през изминалата година.
Когато определяте обхвата на доказателството за стойност (proof of value) спрямо текущата работа, имайте предвид, че някои сигнали, които са били подавени поради ограничения в капацитета, може да си струва да бъдат върнати обратно за това упражнение.
Оценката трябва да надхвърли обработените сигнали и да се фокусира върху TDIR резултатите: средно време за откриване, средно време за реакция, намаляване на фалшивите положителни сигнали и средно време за локализиране/ограничаване като крайна цел, тъй като ограничаването е мястото, където рискът действително се намалява.
Част от тази секция, която повечето процеси по покупка пропускат, е изискването за реални сравнителни показатели (benchmarks) от среди, подобни на техните, и установяването дали тези числа идват от доказателство за концепция (proof of concept) или от продължителна реална експлоатация.
По отношение на скоростта данните от проучването са съществени; от екипите, използващи AI, 72% съобщават за съкращаване на времето за разследване с поне 25%.
Gartner препоръчва въпроси относно общата наличност, клиентската база, финансирането и как се държи ценообразуването при натоварване, като същевременно приема, че консолидацията в тази категория е вероятна.
Повечето доставчици в това пространство започнаха да предоставят решения за случаите на триаж и разследване на сигнали, тъй като в момента това е една от основните болезнени точки за екипите по операции по сигурност. Въвеждането на система, която последователно записва резултатите от разследванията и е способна да прави запитвания и да взаимодейства с множество източници на данни, обаче е силен катализатор на допълнителни възможности в подкрепа на съседни случаи на употреба, като инженерно проектиране на откриването и търсене на заплахи (threat hunting). Естествено и очаквано е да виждаме доставчиците в сферата на AI SOC да разширяват продуктите си в тези посоки.
Устойчивостта на решението трябва да се има предвид дори когато няма включен доставчик. Проучването State of AI in Security Operations разширява този въпрос до решението „създаване спрямо закупуване“ (build vs. buy). 72% от потребителите на AI са се опитали да изградят свои собствени инструменти. Тези разработки първоначално са съвпадали с търговските резултати по основния показател: 73% от екипите, които са изградили собствено решение, съобщават за спестено време за разследване от поне една четвърт, спрямо 72% за потребителите на AI като цяло.
Въпреки това 46% в крайна свен са били изоставени, никога не са стигнали до реална експлоатация или са били заменени от търговски продукт. Това, което се е провалило, е била поддръжката: поддържане на темпото при промяна на инструментите, усвояване на нови типове сигнали и поддържане на стабилна точност, когато инженерите, които са го създали, преминат на друга работа.
Gartner включва набор от по-нюансирани въпроси относно допълването на възможностите и повишаването на квалификацията на аналитиците; едно добро решение трябва да подобрява експертизата на аналитиците, да насърчава непрекъснатото обучение и да осигурява измерими подобрения в ефективността и удовлетвореността на аналитиците.
Данните от проучването са обещаващи; 57% очакват AI да преразпредели ролите в SOC, без да променя броя на служителите през следващите две години, а 9% очакват броят на служителите да нарасне. Очакването е преразпределение; тъй като AI поема разследването от ниво 1 и ниво 2, аналитиците се насочват към реакция при инциденти, търсене на заплахи (threat hunting), инженерно проектиране на откриването и симулиране на противника.
Търсенето на заплахи (threat hunting) наистина е силен кандидат за усвояване на тези ресурси, тъй като осигурява значително намаляване на риска, когато се извършва често. Сред всички анкетирани 38% са имали проактивно търсене, което е разкрило злонамерена дейност, пропусната от техните инструменти за откриване. Откриването се покачва до 49% сред тези, които ловуват ежеседмично или по-често, докато пада до 14% за тези, които провеждат търсения по-рядко от веднъж месечно.
Gartner прави разлика между „човек във веригата“ / human in the loop (при който всяко действие изисква одобрение) и „човек над веригата“ / human on the loop (при който надзорът е стратегически, а не тактически).
Засега практиците са уредили това сравнително консервативно, докато изграждат доверие с избраните от тях решения.
Данните от проучването показват, че 57% все още изискват човек да преглежда всяко AI решение, преди сигналът да бъде затворен. 44% позволяват на AI да препоръчва действия, които след това човек изпълнява, 30% автоматично изпълняват действия с нисък риск, 13% разширяват автоматичното изпълнение до действия със среден риск, а 13% запазват AI само за триаж в режим „само за четене“. Нито един анкетиран не предоставя пълна, неконтролирана автономия.
Автономията, предоставена за всяка категория действия, с одобрение от човек по подразбиране и разширяване на обхвата при натрупване на история от успешни резултати, съответства както на насоките на Gartner, така и на това, което екипите действително правят.
Целта тук е оперативната съвместимост.
Категорията за интеграция на Gartner покрива очакваните области на поддръжка на родна SIEM, EDR, SOAR и идентификация и поставя важен архитектурен въпрос: дали решението изисква централизация на данните, или може да работи в разпределени среди.
Според Gartner и нашите собствени наблюдения на клиенти, AI SOC агентите все по-често се намират редом с друг изкуствен интелект. Gartner пита с колко съществуващи LLM може да работи дадено решение, имайки предвид, че инструментите за ITSM, XDR, SIEM и управление на експозицията вече внедряват свои собствени. Оперативната съвместимост тук означава сътрудничество с инструменти, базирани на изкуствен интелект, вместо състезание с тях.
Твърденията за интеграция са лесни за правене, трудни за валидиране и още по-трудни за изграждане и поддръжка; това е ключов аргумент в полза на купуването пред вътрешното разработване на решение. За тази цел, когато оценяват какво работи в техния технологичен стек, видяхме, че клиентите търсят: дълбочина на интеграцията пред нейната широта, двупосочни синхронизации и лекота на добавяне на нови конектори.
Категорията за прозрачност пита как се обясняват решенията, дали съществуват четими от хора одитни следи за всяко автоматизирано действие, кои LLM технологии на трети страни участват, къде отиват данните на клиентите, дали са налични опции за по-силен суверенитет на данните като локален хостинг и как обратната връзка от аналитиците относно точността се отразява обратно върху настройката.
Данните от проучването поставят тези притеснения на върха на списъка с бариери: поверителността на данните и начинът, по който се обучават моделите, са посочени от 44% от анкетираните, а обяснимостта – от 41%. За щастие и двете могат да бъдат тествани по време на оценката, а не след подписването на договора.
Аналитикът трябва да може да види Всеки въпрос, който системата е задала, Всяка заявка, която е изпълнила към всеки източник, какво се е върнало и как тези доказателства са довели до присъда, след което да копира една от тези заявки и да я изпълни в изходния инструмент, за да потвърди резултата. Разследване, което не може да бъде възстановено или изпълнено отново, не може да бъде защитено пред одитор или пред всеки, който пита защо даден сигнал е бил затворен.
По-широкият набор от критерии, включително управление на случаи, обучение и условия за изход, е покрит в това ръководство за оценка на агентна SOC платформа.
Основният извод
За лидерите в областта на сигурността, които оценяват AI SOC агенти, основният извод е, че подобряването на вашата програма за сигурност изисква структурирана оценка, ориентирана към резултатите.
Стойността на рамката на Gartner е, че тя се противопоставя на обявяването на победители в категория, която бързо се променя, и тласка купувачите към резултати, а не към списъци с функции. Данните от проучването добавят детайли, които една рамка не може да предостави: доказателства, че екипите внедряват бързо, предоставят автономия бавно и виждат подобряване на конкретни резултати.
За организации, които искат да приложат рамката за оценка на Gartner към своя собствен процес на купуване или да прочетат пълния набор от констатации от тазгодишния доклад State of AI in Security Operations, пълните доклади са достъпни за изтегляне.