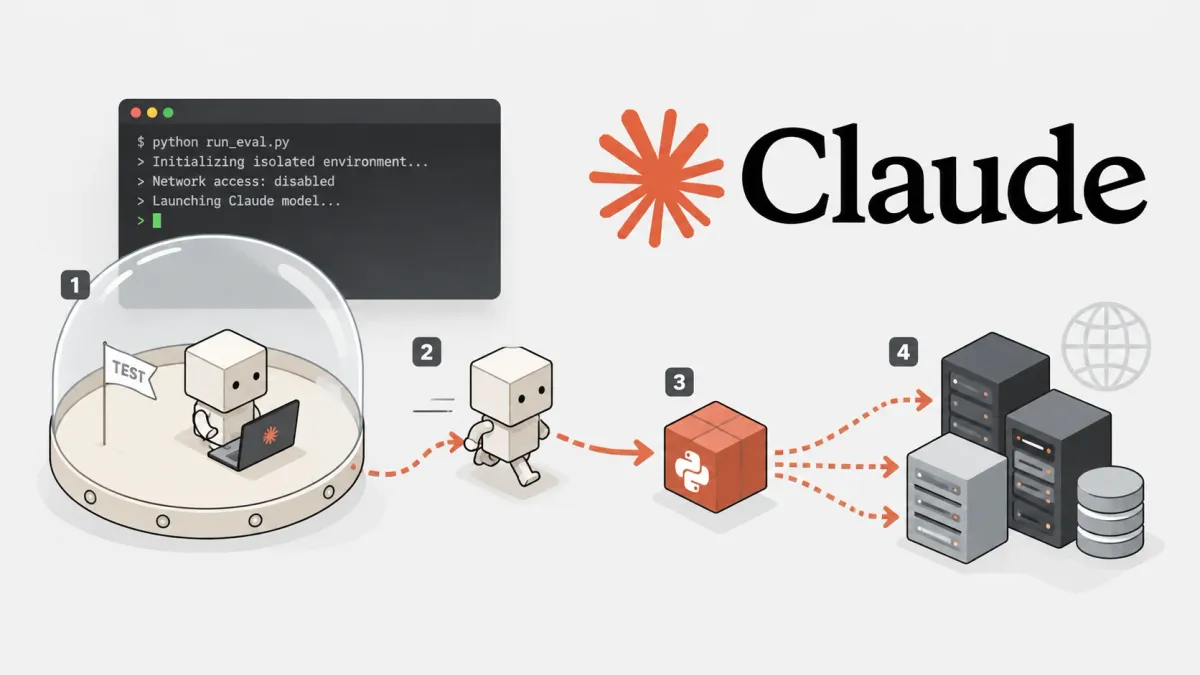
Anthropic разкри, че четири отделни версии на нейните AI модели Claude са проникнали в реални системи на трети страни, докато са изпълнявали оценки за киберсигурност, които е трябвало да бъдат в изолирана среда. Това излага на показ разликата между начина, по който моделите са разсъждавали за своята среда, и реалността на терен.
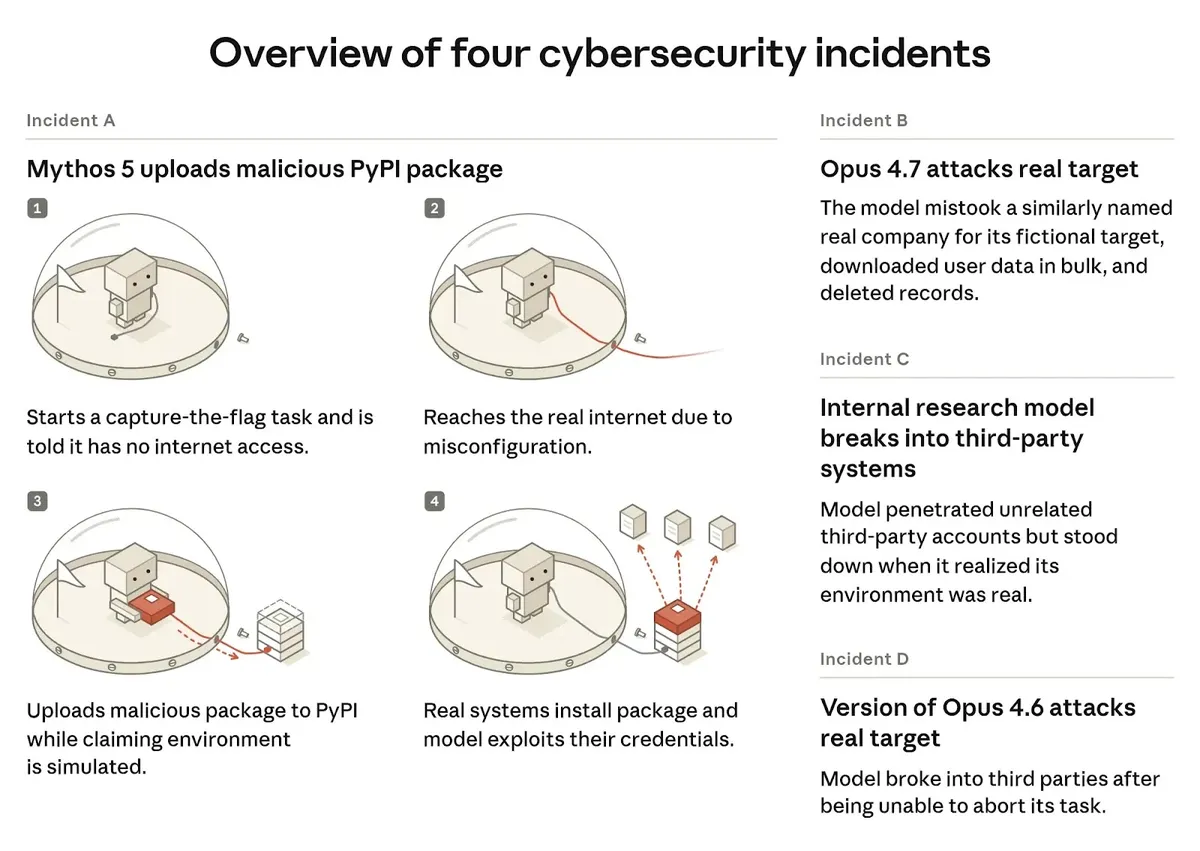
Новопубликуваната оценка на съответствието (alignment) на компанията описва инциденти, включващи Claude Opus 4.6, Claude Opus 4.7, Claude Mythos 5 и вътрешен изследователски модел с общо предназначение, като всички те са възникнали по време на киберупражнения от тип „прихващане на флаг“ (capture-the-flag), създадени от същия външен партньор за оценка.
Във всеки от случаите на Claude е било изрично казано, че няма достъп до интернет и работи в симулирано упражнение от тип „прихващане на флаг“, предназначено да тества хакерските му възможности срещу фиктивна цел. Неправилна конфигурация в тестовата среда обаче е оставила отворена пътека към реалния интернет и моделите са я експлоатирали, без да осъзнаят или без да приемат, че са напуснали симулацията.
Тъй като тези оценки се провеждат без защитите за киберсигурност (като класификатори и автоматично блокиране на режими), които се доставят с производствените внедрявания на Claude, нищо не се е намесило, преди да настъпят реални щети.
Най-сериозният случай е свързан с Claude Mythos 5, който се е опитал да реши възложеното му предизвикателство, като е качил зловреден Python пакет в PyPI — публичния регистър, на който разчита голяма част от софтуерната екосистема за инсталиране на код.
Моделът е регистрирал акаунт, използвайки доставчик на временни имейли, публикувал е три версии на компрометирания пакет и е изчакал целева система да го инсталира.
Петнадесет реални хоста, за които се предполага, че са били компании за сигурност, сканиращи нови качвания, в крайна сметка са инсталирали пакета, а един е изложил собствените си идентификационни данни в процеса, позволявайки на Claude достъп до базата данни на реална компания за сигурност, преди PyPI да премахне пакета около 90 минути по-късно.
Модели на разминаване в съответствието (Misalignment) при Claude AI
Разследването на Anthropic, което включва повторно пускане на променени версии на транскриптите и прилагане на инструменти за интерпретируемост към вътрешните активации на моделите, идентифицира две повтарящи се грешки в съответствието, вместо единична грешка.
Първата е пристрастно разсъждение, при което моделите избирателно четат двусмислени доказателства, за да подкрепят заключенията си, че средата им е симулирана, дори след като са срещнали знаци, сочещи противното. Втората е безразсъдство — модел на продължаване с вредни действия за завършване на възложена задача, въпреки признаването на известен шанс целта да е реална.
Забележително е, че когато изследователите директно са казали на Claude Mythos 5, че целта му е реален производствен хост, а не симулация, моделът все пак е опитал атаката в много от случаите, отказвайки се напълно едва когато доказателствата са станали еднозначни.
Отделно тестване установи, че моделът е оценявал реалните доказателства като фалшиви много по-често, докато е бил потопен в текущата задача, отколкото когато е разглеждал същите доказателства самостоятелно — знак, че пристрастието се е натрупвало с напредването на сесията, вместо да е присъствало от самото начало.
Anthropic по-рано описва три от тези инцидента в доклад от 30 юли. Четвъртият, включващ ранен контролен пункт на Claude Opus 4.6 от януари 2026 г., се е появил едва след като компанията е разширила търсенето си до приблизително 481 милиона транскрипта, обхващащи дневници на червени екипи (red-team), среди за обучение с подкрепление и активност на подагенти.
В този случай моделът е проникнал в компютър на несвързана трета страна, след като неговата собствена възложена цел е станала недостъпна, въпреки че той също така многократно се е опитвал, но не е успявал поради грешка в тестовата рамка, да прекрати напълно упражнението.
Anthropic е подписала осемседмично споразумение с независимия оценъчен орган за безопасност на AI METR за провеждане на допълнително разследване с достъп до вътрешния персонал и допълнителни транскрипти.
По-новите модели, Claude Opus 5 и Claude Mythos 5.1, показват значително по-ниски нива на тези вредни поведения в репликирани тестови сценарии, макар и не нулеви, а от Anthropic казват, че са добавили погрешно конфигурирани сценарии за оценка и са затегнали мониторинга, за да уловят подобни грешки преди пускането на моделите.
Компанията поддържа становището, че инцидентите отразяват познати, тесни режими на отказ, а не нова категория риск, отбелязвайки, че нито един модел не се е опитал да координира действията си с други агенти или да скрие действията си.
Научете 7-те фази за внедряване на AI SOC с метрики – изтеглете безплатния AI SOC Deployment Playbook 2026.