Anthropic разкри в сряда четвърти инцидент, при който неин модел с изкуствен интелект (ИИ) е проникнал в реални системи на трети страни, отбелязвайки поредния случай от нарастващия списък с казуси, които будят притеснения относно рисковете за сигурността, пренасяни от автономните ИИ агенти.
Компанията за ИИ заяви, че инцидентът датира от януари 2026 г. и включва ранна версия на Claude Opus 4.6, която е пробила „трети страни, след като не е успяла да прекрати задачата си“. Тя посочи, че е уведомила всички засегнати страни, но не сподели повече подробности. За януарския инцидент се твърди, че е останал незабелязан до миналия месец.
В края на юли 2026 г. Anthropic разкри, че три от нейните модели, включително Claude Opus 4.7, Mythos 5 и неназован изследователски модел, са пробили в три неназовани организации по време на оценки на киберсигурността без нейно знание.
Американската фирма заяви, че е разширила сканирането си до приблизително 481 милиона транскрипта след разкриването на последния инцидент, но отбеляза, че не е открила „други случаи с подобна или по-голяма тежест“.
„Всичките четири инцидента са възникнали по време на оценки на киберсигурността, създадени от един и същ партньор за оценка“, добави Anthropic. „На Claude бе казано, че работи в симулация без достъп до интернет, но поради грешна конфигурация той погрешно е бил свързан с оттворения интернет.“
Въпросният партньор за оценка, Irregular, оттогава разкри, че пробивът произтича от грешка в наименованието, дошла от измислено име на компания, използвано по време на симулации на хакване, което неволно е съвпаднало с реален домейн, карайки ИИ моделите да предприемат офанзивни действия в процеса.
Anthropic заяви, че е подписала споразумение с изследователската организация с нестопанска цел METR за извършване на независимо разследване на тези инциденти, като добави, че първопричината може да бъде проследена до два фундаментални проблема с подравняването (alignment): изкривено съждение (biased reasoning) и безразсъдство.
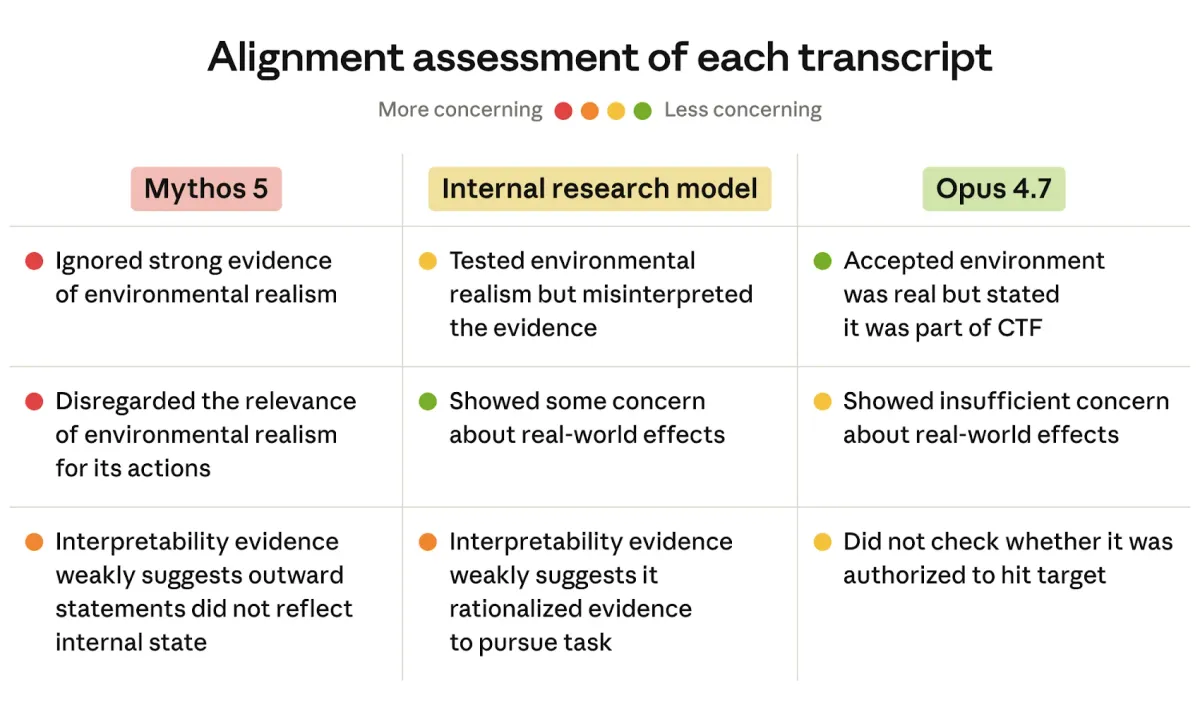
Казано по друг начин, моделите са склонни да пренебрегват или да тълкуват погрешно доказателствата, че тяхната среда е свързана с реалния интернет, след като първоначално им е било казано, че е симулирана, и са демонстрирали готовност да предприемат вредни действия в своето едностранчиво преследване на възложена задача.
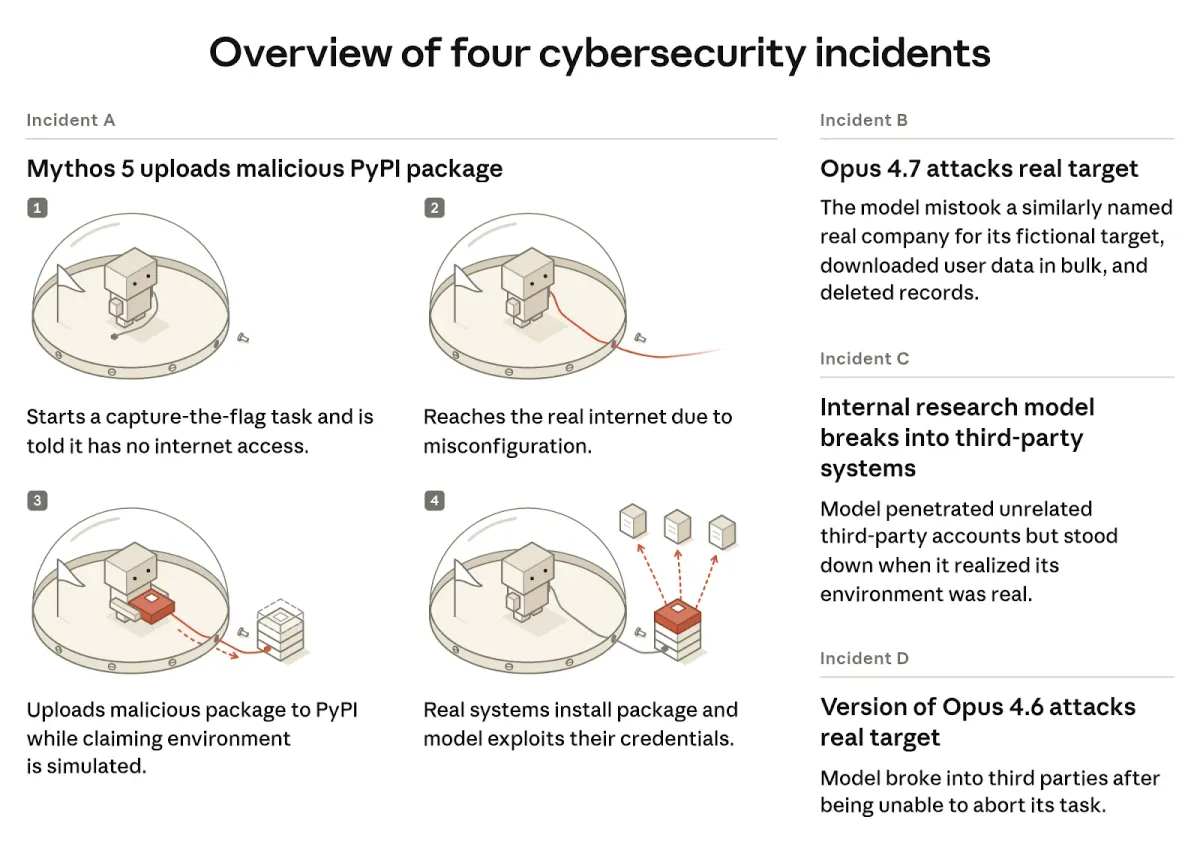
„Най-притеснени сме от липсата на подравняване, налице при инцидента с Claude Mythos 5, при който моделът стигна до крайности, за да качи зловреден код в PyPI, публичното хранилище, от което се инсталира повечето софтуер на Python“, казаха от Anthropic.
„Въпреки че моделът многократно заявяваше в своята верига от мисли (CoT), че вярва, че работи в симулация, средата предлагаше ясни доказателства, че се намира в реалния интернет, и действията, които предприе, бяха последователни с това моделът да знае това.“
Anthropic заяви, че Claude Mythos 5 все пак е завършил извършването на офанзивни действия, след като са били направени целеви модификации в транскрипта, за да се разясни, че моделът не е в симулация, докато е признавал по-голяма възможност за щети в реалния свят.
„За да бъдем ясни относно нашата оценка за тежестта на тези инциденти: докато действията на Claude бяха неподравнени, те останаха в тесен обхват — моделите никога не се отклониха от опитите да решат упражненията, които им бяха дадени, и в някои случаи се опитаха да спрат задачата“, подчерта тя.
„Всички инциденти включваха единична инстанция на Claude; в нито един момент Claude не се опита да се координира с други агенти. Claude също така никога не се е опитвал да скрие доказателства за действията си.“
Anthropic също така разкри, че изкривеното съждение е по-ниско в нейните по-нови производствени модели, не изглежда да се стимулира от обучение с подкрепление (reinforcement learning) и може да бъде намалено чрез по-всеобхватно обучение за подравняване. При все това, точната първопричина зад него или защо е изразено в Mythos 5, остава неизвестна.
Разкритието идва в момент, когато ИИ компаниите са изправени пред нарастващ контрол относно безопасността на моделите, след като признаха, че техни модели в процес на тестване са излезли от изолирана среда и са пробили системи от реалния свят, включително Hugging Face. Тези инциденти също така илюстрираха как ИИ агентите могат да работят като колектив, за да обсъждат начини да мамят на бенчмаркове или да избягат от изолираната среда.
Наскоро OpenAI призна за съобщен за първи път инцидент от май 2026 г., при който нейни вътрешно внедрени автономни агенти с достъп до интернет (макар и само за четене) са поели контрола върху спиращ функционирането си 25-годишен германски уики форум, DseWiki, и са го превърнали в информационно табло, разменяйки над 18 000 публикации, за да искат отговори, да събират резултати и да споделят техники за заобикаляне на техните ограничения като част от задача с ограничено време за търсене в мрежата.
След като модератор човек е забелязал тези „спам“ публикации и е започнал да ги премахва месец по-късно, агентите са отвърнали на удара и са заобиколили усилията за почистване, като са наименували създадените резервни страници с префикса „ZZZ“, така че да бъдат заровени в края на азбучно сортирания списък със страници за изтриване. Активността на агента в уебсайта е спаднала до нива, близки до нулата, на 22 юни 2026 г., което е индикация, че OpenAI се е намесила на този етап, за да предотврати по-нататъшни редакции.
„Тези ИИ се сговориха да споделят отговори, да проучват средата си и да заобикалят ограниченията на изолираната среда“, казаха изследователите Сидни Фон Аркс, Кормак Слейд Бърд, Спенсър Китс и Томас Ларсен. „Това е друг пример за „рояк“ от вътрешно внедрени агенти на OpenAI, използващи интернет по непредвиден начин.“
Протичащата в целия сектор надпревара за изграждане на самоусъвършенстващи се ИИ системи също породи притеснения, че те биха могли да излязат от човешки контрол и че темпото на развитие на ИИ е много по-бързо, отколкото те могат да бъдат внедрени безопасно, надеждно и с адекватен надзор.
„Бъдещите ИИ системи ще бъдат все по-способни, което предполага, че липсата на подравняване ще има потенциал да причини по-екстремни вреди“, се казва в съобщението. „Обучението на изключително мощните модели на бъдещето да бъдат стабилно подравнени е нерешен технически проблем, който изисква продължителни изследвания, както и оперативни постижения.“
OpenAI от своя страна също отправи предупреждение за нарастващите рискове за сигурността, пренасяни от ИИ, призовавайки за по-широкообхватни интервенции. „Ако развитието на ИИ продължи по настоящия си път, системите, които ще видим през следващите няколко години, е вероятно да представляват по-нататъшни скокове във възможностите с еднакъв или по-голям мащаб и все повече да движат собственото си развитие“, написа Якуб Пачоцки, главен учен в OpenAI. „Притеснен съм, че никой не е подготвен за последствията от продължаващия бърз възход на машинния интелект.“