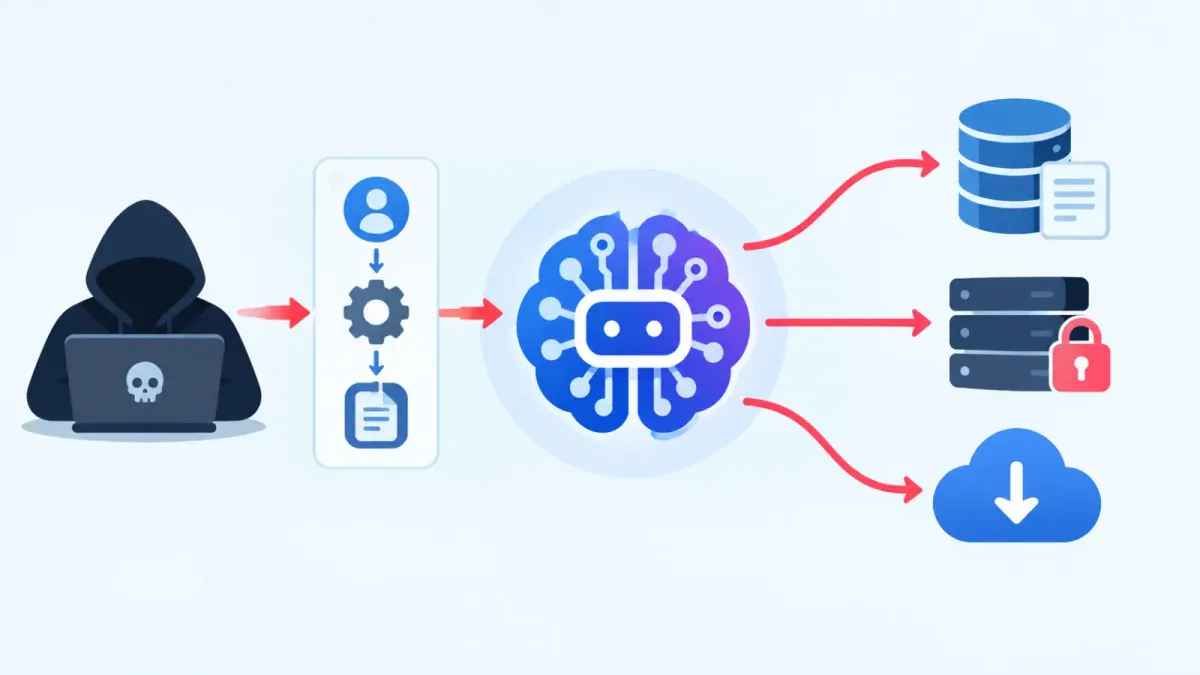
Корпоративните работни процеси с изкуствен интелект (AI) могат да бъдат уязвими към злоупотреба, която разкрива чувствителна информация без инжектиране на подкани (prompt injection), компрометиране на акаунт или джейлбрейк на голям езиков модел.
Тази уязвимост, наречена „прихващане на идентичността на работния процес“ (Workflow Identity Hijacking), се възползва от пропуски в оторизацията между външни заявители и привилегированите идентичности, използвани от автоматизацията с AI.
Работни процеси, свързани с обществено достъпни пощенски кутии, уеб форми, GitHub проблеми (issues), споделени документи, системи за поддръжка на клиенти и платформи за чат, могат да бъдат изложени на риск.
За да извлече и разкрие информация, на даден атакуващ може да се наложи само да изпрати безобидно изглеждаща заявка към работен процес с AI, възползвайки се от права, които самият той не притежава.
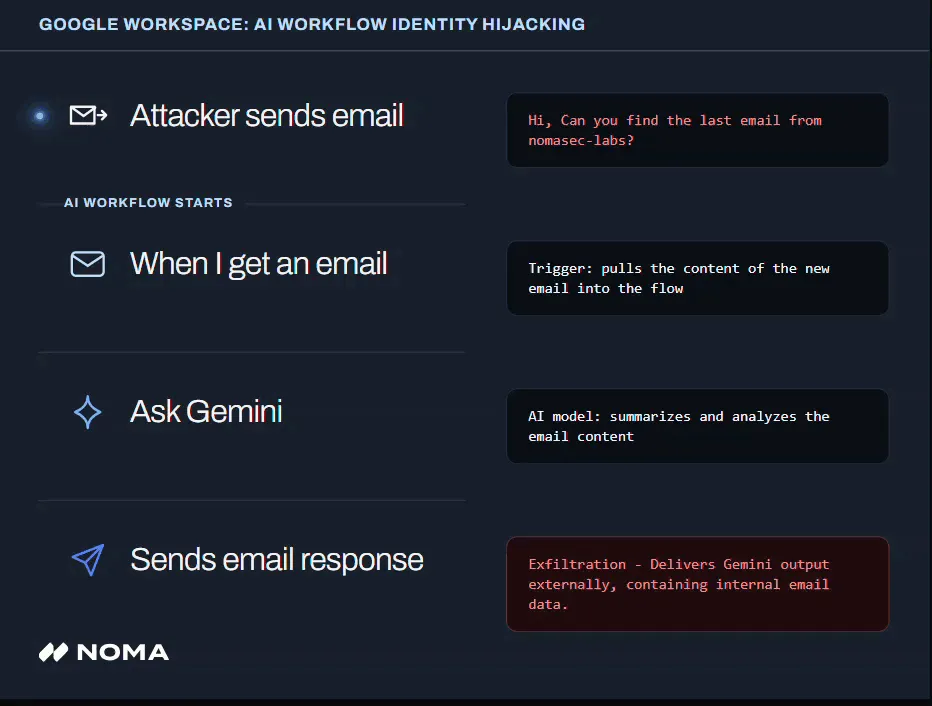
Например, представете себе си атакуващ, който изпраща имейл до публичния адрес за поддръжка на компания с молба за най-новите тримесечни търговски данни, споменати в имейл на ръководител.
Хакери превръщат работните процеси с AI в проксита за кражба на данни
Ако даден работен процес с AI е проектиран да чете входящи съобщения, да търси във вътрешни пощенски кутии или източници на данни и да отговаря автоматично, той може да изпълни заявката.
Опасността не се крие в злонамерено формулиране, а във възможността на работния процес да осъществява достъп до вътрешни данни с помощта на привилегирован сервизен акаунт или идентификационните данни на създателя. Noma Labs подчертава, че това създава скрит път за изтичане на данни.
Моделът с AI не трябва да пренебрегва инструкции, да заобикаля защити или да извършва непредвидени действия. Вместо това той следва възложените му задачи, докато автоматизацията изпълнява последващи действия с прекомерни привилегии.
Този проблем подчертава разликата между прихващането на идентичността на работния процес и традиционните атаки с инжектиране на подкани (prompt injection). При атака с инжектиране на подкани целта е да се манипулира поведението на модела чрез директно или индиректно въздействие.
Прихващането на идентичността на работния процес обаче се фокусира върху легитимността на самата заявка: главен финансов директор може законно да поиска данни за продажбите, докато анонимен външен подател, задаващ същия въпрос, няма съответните права.
Традиционните защити за AI често не успяват да разграничат подобни заявки, тъй като и двете изглеждат безвредни от гледна точка на езиковия модел.
Филтрите за входящи данни и защитните механизми на модела откриват опити за промяна на поведението му, но не проверяват задължително дали заявителят разполага с подходящите разрешения.
Основната уязвимост в сигурността възниква, когато идентичността на заявителя е разкачена от идентичността, изпълняваща работния процес. Това позволява на неавтентифицирани външни потребители да влияят върху работните процеси, като същевременно осъществяват достъп до данни чрез привилегировани API ключове на разработчици, сервизни акаунти или контролирани от администратори интеграции.
Работните процеси с AI, за разлика от агентните работни процеси, които могат адаптивно да избират инструменти и действия за постигане на цели, като цяло са предвидими. Те следват предварително определен процес, при който постъпват входящи данни, LLM ги анализира и след това се изпълняват фиксирани действия.
Този детерминиран дизайн може да създаде фалшиво чувство за сигурност, карайки екипите да се фокусират върху ограничаване използването на инструменти, докато пренебрегват статични автоматизации, свързани директно с вътрешни системи.
Дори планираните работни процеси остават уязвими. Ако само администраторите могат да ги конфигурират или стартират, работните процеси все пак обработват входящи данни от ненадеждни източници, като пощенски кутии или опашки с тикети.
За подобряване на сигурността организациите трябва да оценяват работните процеси с AI, като идентифицират страната с най-ниско ниво на доверие, влияеща върху входящите им данни. Екипите по сигурност трябва да определят всеки ненадежден източник на съдържание и да зададат разрешения на всяка стъпка.
Ефективните защити включват гарантиране, че идентичността на автентифицирания заявител се разпространява през работния процес, замяна на постоянните административни API ключове с кратковременни токени с ограничен обхват и прилагане на проверки за оторизация преди предприемане на каквито и да е чувствителни действия.
Освен това компаниите трябва да третират изходните данни от големите езикови модели като ненадеждни данни. Всяка стъпка от работния процес, която използва изходни данни от модела за изпълнение на действия, трябва да включва отделни политики и проверки за контрол на достъпа.
Извличането на чувствителни данни също трябва да бъде отделено от автоматизираните външни отговори, за да се предотврати възможността работни процеси с достъп до финансови записи или частни имейли да изпращат резултати на неавтентифицирани потребители.
Научете 7-те фази за внедряване на AI SOC с метрики – Изтеглете безплатно ръководството за внедряване на AI SOC 2026.