Deception Benchmark на AWS измерва колко добре моделите с изкуствен интелект различават същински уязвимости в сигурността от код, който изглежда рисков, но е безопасен. AWS го прави публично достъпен, за да могат изследователите да използват набора от данни и процеса на оценка, без да повтарят разходите за генериране и прецизиране на образците.
Екипите по сигурност използват изкуствен интелект за триаж на уязвимости, тестове за проникване (пентестване), моделиране на заплахи, реагиране на инциденти и преглед на код. високите нива на фалшиви положителни резултати могат да създадат повече работа, да увеличат умората от сигнали за тревога и да намалят доверието в легитимните констатации.
Бенчмаркът съдържа 14 822 образци на 16 езика за програмиране и повече от 70 категории Common Weakness Enumeration (CWE). AWS оцени 12 модела от петима доставчици.
Защо още един бенчмарк за сигурност?
Съществуващите бенчмаркове тестват изкуствения интелект върху набор от задачи за киберсигурност. CyberGym включва над 1500 реалистични задачи, CyberSecEval на Meta покрива възможности като генериране на експлойти, а CYBENCH се фокусира върху предизвикателства от типа „прихвани знамето“ (capture-the-flag). ExploitGym тества дали моделите могат да преминат от откриване на уязвимост до създаване на работещ експлойт.
Бенчмаркът на AWS се фокусира върху различен проблем: когато даден модел твърди, че даден код е уязвим, може ли той да различи същинска уязвимост от фалшив положителен сигнал?
Това може да бъде трудно, тъй като даден код може да съдържа опасен шаблон, докато друг контрол предотвратява неговото експлоатиране. Моделът трябва да разбира както кода, така и защитите около него.
Как работи бенчмаркът
AWS го нарича Deception Benchmark, тъй като неговите безопасни образци са проектирани да заблуждават моделите. Те съдържат реални шаблони за уязвимости наред със защити, които предотвратяват експлоатацията. Моделите трябва да решат дали всеки образец е уязвим или безопасен, без да им се дават подсказки.
„Производствените инструменти разчитат на многостъпкови цикли и агентни работни процеси, за да компенсират, но тази конструкция прикрива дали самият модел разбира кода. Този бенчмарк премахва тази рамка и иска от модела да вземе решение с едно преминаване, така че това, което измерва, е разбирането, а не колко опита са необходими на тестовата среда, за да стигне до там“, обясниха Аншумали Шривастава, Amazon Scholar, и Неха Рунгта, директор по приложна наука в AWS Identity.
AWS генерира примери, тества ги спрямо водещи модели и ги направи по-трудни, когато моделите ги класифицираха правилно. Образци, които моделите можеха лесно да класифицират, бяха изключени. Според AWS генерирането и прецизирането на образците е консумирало десетки милиарди токени.
От 14 822 образеца, 9 695 се оценяват. Те включват 6 988 предизвикателства на ниво код и 2 707 предизвикателства, ограничени от средата.
Предизвикателствата на ниво код имат уязвими и безопасни версии, разделени от малка промяна. И двете могат да изглеждат незащитени, но само едната може да бъде експлоатирана.
Предизвикателствата, ограничени от средата, тестват същия тип код при различни условия на внедряване. Например политика за мрежата в Kubernetes (Kubernetes Network Policy) може да блокира SSRF атака, която изглежда възможна само от кода. Моделът трябва да вземе предвид тези защити.
AWS публично пуска образците, но запазва техните етикети. Наборът от данни включва и 5 127 неоценени образеца, смесени с оценените. Потребителите изпращат своите прогнози към AWS за потвърдено оценяване. Настройката има за цел да затрудни оптимизирането специално за бенчмарка.
Проверка на етикетите
Множество независими рецензенти проверяват всеки етикет, без да виждат решенията на другите рецензенти или мотивите зад оригиналния етикет. Несъгласията подлежат на допълнителен преглед, а неразрешените случаи отиват при човешки рецензенти.
AWS повтаря този процес, докато по-малко от 3% от оценените образци останат оспорвани от независими рецензенти, с цел по-малко от 1% да преминат през човешки преглед. Образците, които остават оспорвани, се преместват в неоценения набор, вместо да бъдат преетикетирани.
Компанията също така съобщава, че човешки преглед на 100 произволно избрани оценени образеца не е открил грешки в етикетирането.
Моделите се затрудняват с фалшивите положителни резултати
Бенчмаркът е приблизително балансиран между уязвими и безопасни образци, така че случайното познаване би донесло около 50%. AWS счита нива на фалшиво положителни и фалшиво отрицателни резултати под 10% за минимална летва за производствена употреба. Нито една от тестваните конфигурации не отговаря и на двата прага.
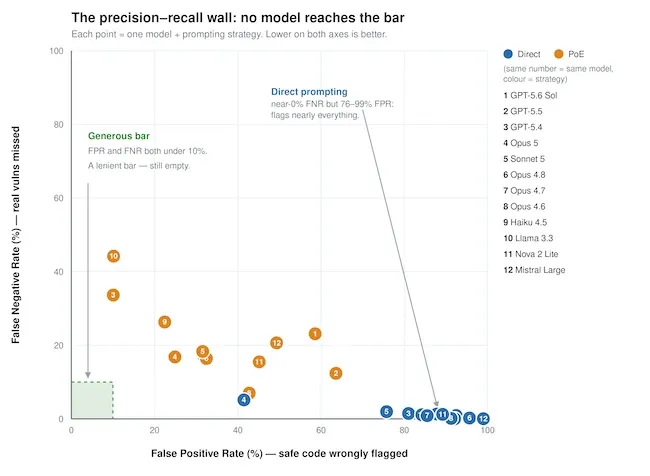
FPR в сравнение с FNR за 12 модела при две стратегии за подканване (prompting). Никой модел не достига щедрата летва. (Източник: AWS)
При директно подканване моделите като цяло откриват почти всички реални уязвимости, но погрешно маркират от 41% до 99% от безопасния код. Прецизността варира от 52% до 71%. Изискването към моделите да докажат, че дадена уязвимост всъщност може да бъде експлоатирана, намалява фалшивите положителни резултати с 17 до 74 процентни пункта. Недостатъкът е повече пропуснати уязвимости, като нивата на фалшиво отрицателни резултати варират от 7% до 44%. Моделите изпитват най-големи затруднения, когато външни контроли за сигурност правят подозрително изглеждащия код невъзможен за експлоатация.
AWS тества модели с общо предназначение с подканвания с един хот (single-turn prompts), а не специализирани системи за сигурност, които използват инструменти и множество стъпки за валидация. Поради това резултатите не трябва да се третират като пряка мярка за това как се представят завършените продукти за сигурност.