Твърдо кодирани API ключове, токени за достъп и други идентификационни данни, използвани от AI инструменти за кодиране, са намерени в публично достъпни MCP конфигурационни файлове в GitHub, според проучване от доклада „The State of MCP Configuration: The Identity Security Gaps“ на Hush Security.
Компанията е анализирала около 82 000 конфигурационни файла и е установила, че 12% от слотовете за идентификационни данни съдържат твърдо кодирани стойности, което потенциално излага на риск данните за достъп до свързани услуги и системи.
3>Как бяха идентифицирани разкритите идентификационни данниИзследователите са търсили в публични хранилища в GitHub за имена на конфигурационни файлове, използвани от основни асистенти за програмиране (coding agents). Те са изследвали стойностите на променливите на средата и заглавните части за автентификация (authentication headers), класифицирайки слотовете според начина, по който е била съхранявана информацията за автентификация.
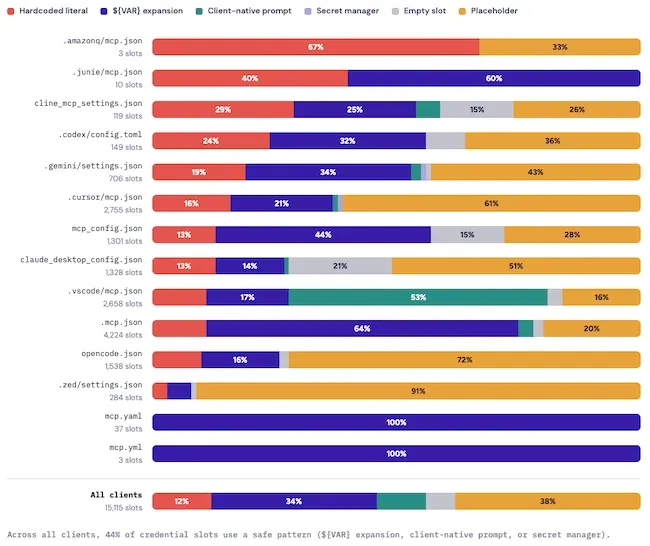
Как всеки слот за идентификационни данни получава своята стойност (Източник: Hush Security)
Категориите включват твърдо кодирани стойности, референции към променливи на средата, подкани, управлявани от клиента, референции към мениджъри на тайни (secret managers), заместители (placeholders) и празни полета. Изследователите са идентифицирали вероятни тайни в твърдо кодираните стойности с помощта на специфични за доставчиците шаблони и ентропия на Шанън, която измерва случайността.
Търсенето на код в GitHub индексира основните клонове (default branches), изключва форкове (forks) и ограничава резултатите за отделните заявки. Поради това Hush третира докладваните данни като оценки за долна граница, а не като точен брой на изложените идентификационни данни.
Няколко файла, включени в проучването, са били общи конфигурационни файлове, които незадължително могат да съдържат MCP настройки. В тези случаи изследователите са отчели само извадените файлове, които декларират MCP сървър. Те не са опитвали да се автентифицират в каквито и да е услуги, използвайки откритите стойности.
Някои идентификационни данни може да са били отменени или ротирани, откакто са били качени (committed). От твърдо кодираните тайни 55% са нямали разпознаваем от доставчика формат на токена, включително 31%, класифицирани като непрозрачни bearer токени за вътрешни MCP сървъри.
За стойности без разпознаваем формат, специфичен за доставчик, изследователите са използвали имена на ключове, дължина, ентропия и шаблони от символи, за да преценят дали е вероятно те да са идентификационни данни. Техният анализ установи, че тези стойности се състоят предимно от API ключове на доставчици, bearer токени и пароли за бази данни, като неконфиденциалните идентификатори съставляват незначителен дял.
Не са запазени необработени тайни стойности. Констатациите са обобщени и анонимизирани, за да се предотврати идентифицирането на отделни хранилища или автори.
3>Изтритите тайни могат да останат в Git историятаПремахването на чувствителна информация от най-новата версия на даден файл може да не я премахне от хранилището. Git запазва предишни версии, оставяйки изтритите стойности достъпни чрез историята на комитите (commit history).
Изследователите са проучили историята на 7 681 конфигурации, съдържащи идентификационни данни, разглеждайки до седем ревизии преди текущата версия. Те са идентифицирали 243 конфигурации, в които дадена тайна е била премахната от текущия файл, но е останала в по-ранен комит.
Ротацията на засегнатите идентификационни данни при доставчика е необходима за прекратяване на излагането на риск, тъй като изтриването им от текущата конфигурация не ги премахва от Git историята.
„Инстинктът, за който всеки екип по сигурност се обучава от години – да сканира за тайни, да блокира комита и да ротира онова, което е изтекло – тук далеч не е достатъчен“, казва Миха Раве, главен изпълнителен директор на Hush Security. „Тези файлове са предназначени да бъдат качвани в хранилището; тайната никога не трябва да бъде там. Когато е качена, идентификационните данни с най-висок риск в тях не съответстват на нито един известен шаблон, а самоличностите зад тях нямат собственик и нямат срок на валидност. Това е цяла популация от токени за достъп, стоящи в публичния Git, без никой да ги наблюдава.“
От твърдо кодираните литерали на идентификационни данни, 24% са от типове, които по дизайн са както с широк обхват, така и без срок на валидност.
53% от идентификационните данни с класифициран обхват са осигурявали достъп в рамките на цялата организация, акаунт, работно пространство или база данни. За идентификационни данни с дефинирана политика за изтичане, 80% не са изтичали по подразбиране.
Дълготрайните идентификационни данни с обширни разрешения могат да увеличат въздействието при компрометиране, тъй като едни и същи данни за достъп могат да осигурят достъп до множество ресурси или чувствителни функции.
3>MCP задълбочава проблема с нечовешките самоличности (machine identities)MCP връзките могат да дадат разрешение на AI асистентите да взаимодействат с изходен код, бази данни, облачна инфраструктура и други услуги от името на потребители или организации.
Тези асистенти функционират като нечовешки самоличности (non-human identities), използвайки данни за достъп за автентификация в системите, без да се изисква човек да се влиза в системата при всяко взаимодействие. С нарастването на тяхната употреба организациите трябва да проследяват кои асистенти имат достъп, какви разрешения притежават, кой носи отговорност за тях и кога този достъп трябва да прекратен.