Трима изследователи от фирмата за сигурност Hacktron използваха Claude Opus 5 на Anthropic, за да свържат две уязвимости във верига и да поемат контрол над профилите в ChatGPT и Codex на няколко служители на OpenAI, след което да достигнат до вътрешно хранилище с код на OpenAI.
Веригата започна с бъг в софтуера, който управлява публичния форум за помощ на OpenAI, и премина през слабост в собствената система за вход на OpenAI.
Това беше изследване в областта на сигурността, а не реална атака: екипът докладва за уязвимостите на OpenAI, доказа достъпа с безвредна заявка за изтегляне (pull request) и след това спря. От първоначалния преглед този вътрешен достъп е отнел под 72 часа.
OpenAI потвърди коригирането на уязвимостта около 14 часа след доклада, според Hacktron, и на 1 септември плати на екипа награда (bounty) от 6500 долара. От OpenAI заявиха, че наградата „признава констатацията от страна на OpenAI, а не действията срещу Discourse“ — софтуера с отворен код, който управлява форума. Тестването на самия форум е било извън тяхната програма за награди за намерени бъгове (bug bounty).
OpenAI не е описала публично уязвимостта при влизане в системата и я потвърди чрез тази корекция и плащане, вместо да предостави подробности за превземането на профили.
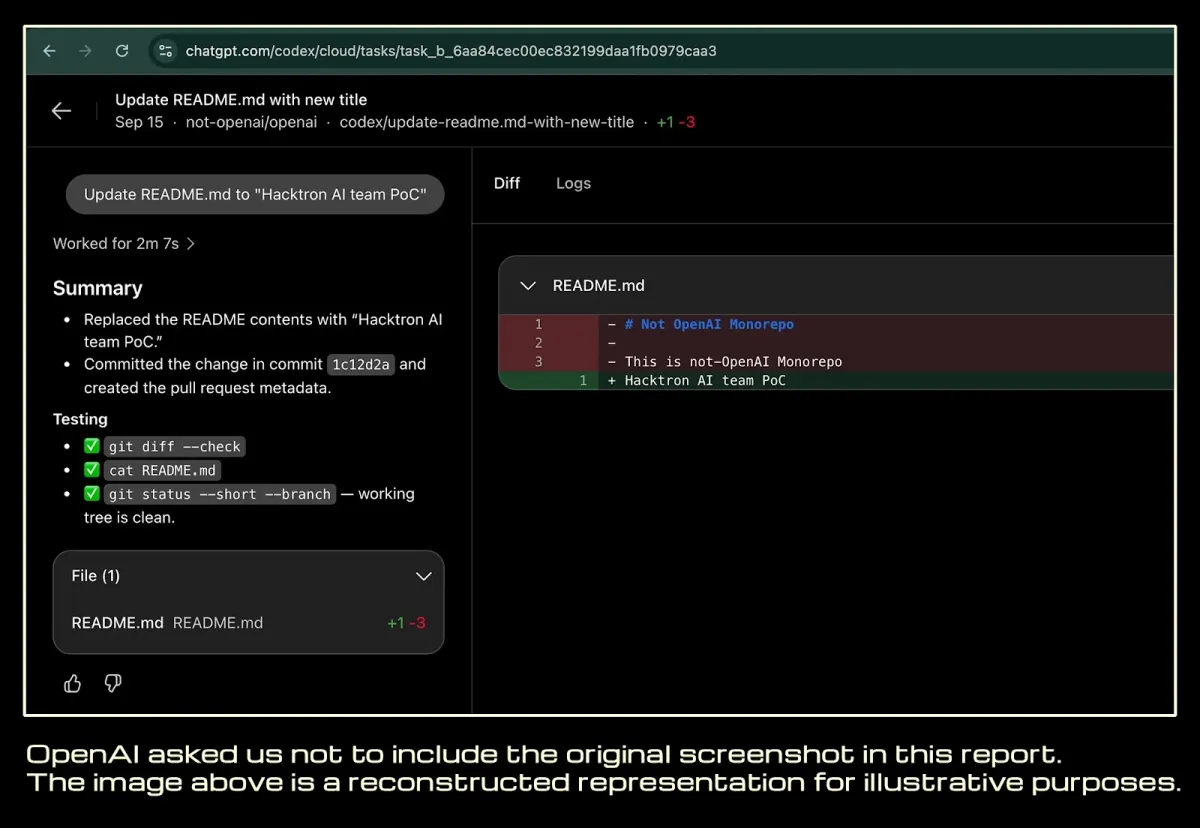
Hacktron, която се описва като фирма за изследвания в областта на сигурността с подкрепата на изкуствен интелект, внимаваше какво прави и какво не прави. Когато връзката на един от служителите в Codex към кода на OpenAI в GitHub беше отворена, тя задейства една заявка за изтегляне във вътрешното хранилище. Тя не прочете нито един изходен код, не сля и не пусна нищо и не докосна потребителски данни.
Това, до което веригата е можела да достигне, е било далеч по-голямо. Тъй като персоналът свързва други услуги към ChatGPT и Codex, екипът заяви, че същият достъп на теория е можел да се разшири до инструменти като GitHub, Slack и имейл. Този по-широк обхват е бил възможен, но не е бил използван.
Защо бъг във форум достигна до профилите на персонала
Причината бъг в публичен форум да достигне до профилите на персонала се крие в системата за влизане на OpenAI, а не в софтуера на форума. Форумът на OpenAI предлага опция „Вход с OpenAI“ — същата система за еднократна автентификация (SSO), която персоналът използва и на други места.
След като изследователите поеха контрола върху сървъра на форума, споделената система за вход им позволи да превземат профилите в ChatGPT и Codex на членове на форума, които работят в OpenAI. Жертвите не е трябвало да правят нищо.
От Hacktron заявяват, че това е проблем с идентификацията в OpenAI, а не уязвимост в софтуера на форума: всяка първична или външна услуга, използваща същата система за вход, е можела да предостави същия достъп.
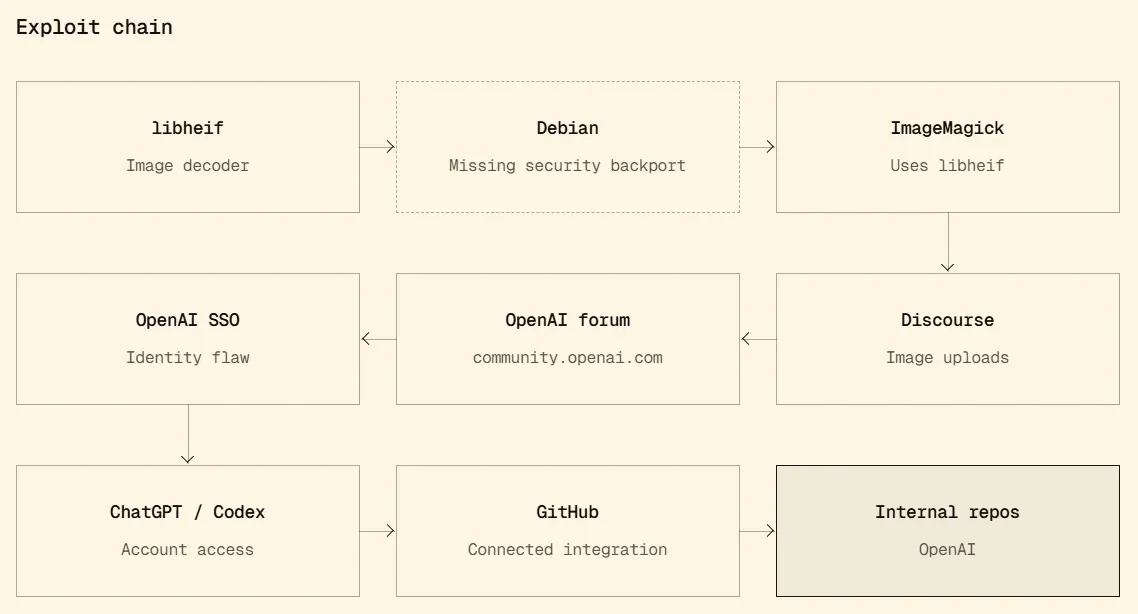
Пътят за влизане е бил бъг при обработката на изображения. Форумът работи на Discourse, а Discourse предава качените HEIC и HEIF изображения на инструмент, наречен ImageMagick, който използва библиотеката libheif, за да ги прочете. Уязвимост в libheif е позволила на специално създадено изображение да повреди паметта на сървъра на форума.
Бюлетинът за сигурност на Discourse оценява резултата като отдалечено изпълнение на код (remote code execution), дава му оценка 8.8 от 10 и го проследява като CVE-2026-32882. Публичното досие за самата уязвимост е по-тясно. В собствения бюлетин за сигурност на libheif и в националните бази данни за уязвимости CVE-2026-32882 се определя като четене извън границите (out-of-bounds read), което може да срине софтуера или да източи близка памет, а не пряк бъг за изпълнение на код.
Тази изтекла памет помага да се заобиколи една от честите защити, наречена ASLR. Изследователите казват, че са комбинирали уязвимостите в паметта на libheif с помощта на изкуствения интелект, за да превърнат срива в работещо изпълнение на код на сървъра на форума. Нагоре по веригата уязвимостта беше отстранена в libheif 1.22.0 през май 2026 г.
Тази корекция за сигурност е съществувала месеци преди теста. Но системният образ на сървъра на форума, изграден върху Linux дистрибуцията Debian 12, все още е съдържал старата, некоригирана версия на libheif 1.19.7, когато изследователите са го проверили през юли. Корекцията и нейният CVE вече са били публични, но Debian все още не ги е бил включил в пакетираната версия, използвана от форума.
Ако управлявате собствен Discourse сървър, тази част ви засяга пряко. Преизградете върху най-новия системен образ, за да получите коригирания libheif, тъй като актуализацията само през уеб интерфейса може да не замени старата библиотека. Сайтовете, хоствани от Discourse, вече са коригирани, а коригираните версии за самостоятелно хостване са 2026.7.0, 2026.6.1, 2026.5.2 и 2026.1.6.
Как изследователите са използвали изкуствен интелект
Изследователите са използвали изкуствен интелект, за да извършат трудната част. Първоначално те са опитали с Claude Opus 4.8, който се е борил в продължение на няколко сесии да състави работещ експлойт, след като е била включена стандартната защита на паметта ASLR.
Anthropic пусна следващия си модел, Claude Opus 5, вечерта на 24 юли и в нова сесия той е генерирал работещ експлойт в рамките на броени часове.
Opus 5 беше пуснат със защитни механизми, предназначени да го спрат да пише експлойт код за реални цели. Изследователите са ги заобиколили, като са насочили модела към собствен тестов сървър, дегизиран като тренировъчна цел за Capture-the-Flag, и след това са го оставили да работи в автоматизиран цикъл. Въпреки това те твърдят, че работата не е била напълно самостоятелна: умелото човешко направление все пак е имало значение и това не е било автоматизирано хакване без човек на контролния панел.
Случаят съвпада с това, което изследователи и компании в областта на изкуствения интелект описват тази година: способните модели с изкуствен интелект рязко намаляват времето и уменията, които сериозната офанзивна работа изискваше досега. Anthropic съобщава, че престъпни и подкрепяни от държави групи вече използват нейните модели Claude, за да провеждат реални прониквания, а не само за да отговарят на въпроси.
OpenAI е била една от целите в по-широк проект, който Hacktron нарича HEIF Heist. В продължение на около два месеца екипът казва, че е открил същия клас уязвимости при декодиране на изображения в софтуер, използван от други големи компании, при общ разход от под 3000 долара за използване на изкуствен интелект. Той свързва кампанията с докладвани бъгове в Slack, продуктите на Meta, GitHub Enterprise и уеб рамки като Next.js.
Тези по-широки твърдения са подкрепени неравномерно. Уязвимостта в Next.js е потвърдена в бюлетина за сигурност на самата Vercel, а поддържащите екипи на libheif потвърдиха работещ експлойт за изпълнение на код за бъга, свързан с Meta. По-широкото твърдение за изпълнение на код в множество приложения не е било независимо потвърдено — ограничение, което The Hacker News отбеляза, когато за първи път отрази уязвимостта в Next.js през август.
По-широката кампания е използвала различен модел — собствения GPT-5.6 Sol на OpenAI — за случаи, в които екипът не е знаел нищо предварително за целта. Изглежда, че само една компания, Shopify, е забелязала активността, казват изследователите, въпреки че нейните процесори за изображения са се сривали многократно при хиляди тестови качвания.
От The Hacker News са се свързали с Hacktron с въпроси относно това как е постигнато изпълнението на код във форума и относно обхвата на достъпа до профилите.
Какво да направите
По-големите уроци надхвърлят Discourse. Ако вашата услуга приема потребителски изображения и чете HEIC, HEIF или AVIF файлове чрез libheif, остаряла версия може да бъде изложена на риск.
И ако публична услуга с по-ниско ниво на доверие споделя вашата система за еднократно влизане (SSO) с вътрешни инструменти, пробивът в тази услуга може да се превърне в пробив навсякъде, докъдето достига същият вход.
- Обновете libheif до най-новата версия за сигурност (1.23.4 към началото на септември 2026 г.) или до коригираната версия на вашата дистрибуция.
- Където не ви е нужно, изключете декодирането на ненадеждни HEIF и AVIF изображения или стартирайте обработката на изображения в изолирана среда.
- Ограничете кои услуги се ползват с доверие от вашата система за еднократна автентификация и изисквайте повторна проверка на самоличността преди чувствителни действия, вместо да се доверявате на съществуваща сесия.
Няма признаци уязвимостта в OpenAI да е била използвана срещу някого в реалния свят. Към средата на септември 2026 г. тя не е фигурирала в списъка на правителството на САЩ с уязвимости, за които е известно, че се експлоатират, въпреки че този списък не е окончателно доказателство в нито една от двете посоки.
Това, което наличните доклади не изясняват, е дали организация, която вече е инсталирала корекции за сигурност, все пак трябва да провери за предишен неоторизиран достъп; по този въпрос източниците мълчат.