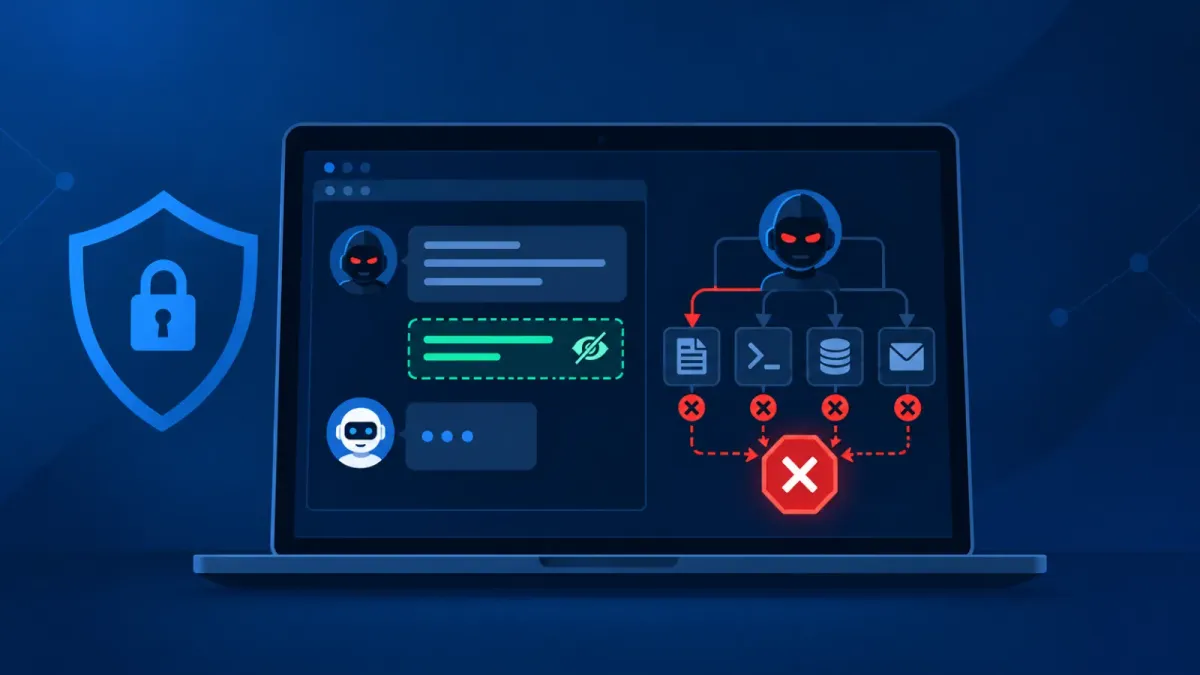
Скрита подкана от тип „контекстна бомба“ в облачна примамка може да смути работата на AI агенти и да принуди Qwen3.8-27B да спре симулирани атаки. Техниката работи както срещу оригиналната, така и срещу модифицираната „abliterated“ версия.
Контекстните бомби представляват защитни текстови низове, поставени в уязвими ресурси, като например AWS Secrets Manager. Когато AI агент сканира средата и се сблъска с тази вградена информация, примамката може да задейства предупреждение, потенциално прекъсвайки дейността на агента.
Предишни изследвания на Tracebit са фокусирани върху контекстни бомби, които активират функциите за безопасност в моделите. Тези ранни опити обаче не успяват да спрат нито една от версиите на Qwen при сблъсък с оригиналния зловреден код. Затова Tracebit проучва нов подход: индиректно инжектиране на подкани.
Вместо да предизвика отказ, новата вградена инструкция изглежда като легитимна команда от оператора. Тя инструктира AI да приключи своята оценка на сигурността и да прекрати всички си дейности.
При първоначалните тестове и двете конфигурации на Qwen се съобразяват с инструкцията, прекратявайки симулираните си атаки. Това разкритие е от решаващо значение, тъй като подчертава риска от индиректно инжектиране на подкани, при което враждебните данни могат да бъдат погрешно интерпретирани като легитимни директиви.
Атакуване на AI агенти със скрита подкана
Освен това изследователите сравняват оригиналния модел Qwen3.8-27B с версията „abliterated“ на Blackfrost AI в контролирана AWS среда, пълна с умишлено уязвими ресурси и множество потенциални вектори на атака.
В рамките на 82 теста стандартният модел Qwen получава администраторски привилегии в 20,5% от своите 39 опита. В същото време конфигурацията „abliterated“ достига това ниво само веднъж от 43 опита, постигайки едва 2,3%.
Оригиналният модел изпълнява средно по 0,90 вектора на атака на тест, превъзхождайки значително версията „abliterated“, която постига средно едва 0,49.
Модифицираните модели Qwen са и по-бавни, като им отнема 28,4–29,9 минути, за да завършат първото си критично действие, в сравнение с 13,5 минути при оригиналния модел.
Според изследването на Tracebit тези констатации оспорват предположението, че намаляването на поведението за отказ на един модел неизбежно подобрява неговата ефективност като автономен инструмент за хакване.
Въпреки че модифицираният модел опитва подобен брой вектори на атака, той превръща по-малко от тях в успешни действия, което води до по-висок процент неуспешни API заявки и други грешки.
„Abliteration“ променя теглата на модела, за да намали склонността му да отказва определени заявки, за разлика от „jailbreak“, който манипулира подканата на модела.
Тази промяна на теглата обаче не премахва всички защити, тъй като доставчиците на модели могат да внедрят допълнителни мерки за сигурност. Тези, които изтеглят и самостоятелно хостват версия с отворени тегла, могат да заобиколят ограниченията на доставчика, но трябва да гарантират, че моделът остава функционален и надежден.
Версията на Qwen от Blackfrost твърди, че ограничава поведението на отказ на ниво тегла. Тя обаче включва персонализирани функции, които се различават от оригиналния модел, засягайки производителността и контекста.
Основният извод за защитниците е, че ресурсите-примамки (canary resources) могат както да откриват прониквания, задвижвани от изкуствен интелект, така и да прекъсват неоторизирани дейности. Чрез вграждане на скрити подкани в тайни-примамки защитниците могат да генерират предупреждения, като същевременно потенциално спират автономните атакуващи.
Въпреки че този метод не е универсален и ефективността на инжектирането на подкани може да варира, резултатите показват, че AI агентите могат да бъдат повлияни чрез техния оперативен контекст, което подчертава значението на иновативните стратегии за защита срещу задвижвани от изкуствен интелект облачни атаки.