OpenAI разшири серията GPT-6 с моделите GPT-6 Sol и GPT-6 Luna. И двата модела са налични в ChatGPT Work и Codex за потребители на плановете Plus, Pro, Business, Enterprise и Edu. Потребителите на безплатния план Free и Go имат достъп до GPT-6 Luna в десктоп приложението. Моделите все още не са достъпни в Chat. Потребителите на OpenAI API могат да ги използват под имената gpt-6-sol и gpt-6-luna.
В ход е поетапно внедряване в ChatGPT с цел запазване стабилността на услугата.
Производителност и разходи
GPT-6 Sol осигурява по-добри резултати при сложни работни задачи, предоставяйки на потребителите повече възможности за итерации. В тестовете AutomationBench, Sol при ниво xhigh effort превъзхожда Claude Opus 5 при max effort, като същевременно струва с 91% по-малко за задача. Моделът изпреварва и GPT-6 Astra при low effort.
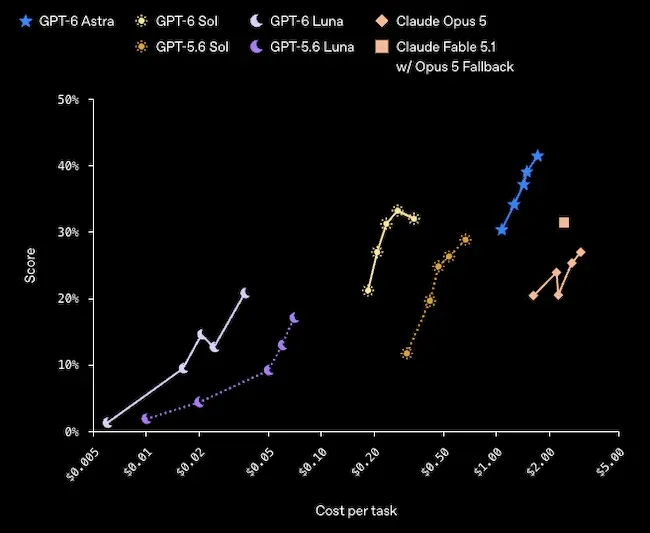
В AutomationBench 1.0.6 (отваря се в нов прозорец) автономните AI агенти се тестват върху цялостни работни процеси с помощта на 47 инструмента в области като продажби, маркетинг, операции, поддръжка, финанси и ЧР. Данните за Claude Fable 5.1 подценяват резултатите (Източник: OpenAI)
При high effort GPT-6 Luna надмина своя предшественик с 5,4 процентни пункта, намалявайки цената на задача с 58%.
OpenAI оцени моделите при сложни професионални работни процеси чрез Agents’ Last Exam. GPT-6 Sol при max effort постигна резултат от 56,4%, надминавайки най-високия резултат на Claude Opus 5 в оценяването при 60% по-ниска цена на задача.
Фактологическа точност и програмиране
Оценката на фактологическата точност на OpenAI използва деидентифицирани реални разговори, в които потребители са маркирали грешки на модела. Компанията посочва, че фактическата коректност е от ключово значение за полезността на отговорите. GPT-6 Sol се доближава до надеждността на Astra на по-ниска цена и допуска приблизително два пъти по-малко грешки от своя предшественик. При по-високи нива на усилие Luna се изравни с GPT-5.6 Sol при около сто пъти по-ниска цена.
Агентите за програмиране поемат все по-големи и по-сложни задачи, чието изпълнение отнема повече време, като използването им в рамките на OpenAI нараства експоненциално през тази година. Изчислено по API цени, дневното потребление на токени надхвърля 600 долара за медианния изследовател и 7000 долара за изследователите в 90-ия персентил.
„Агентите за кодиране поемат по-дълги и по-взискателни задачи, което прави цената на продължителната им употреба все по-важна. GPT-6 Sol и Luna съчетават висока производителност при писане на код с по-ниски API цени. Това дава на разработчиците по-голяма свобода за итерации и позволява на екипите да възлагат по-амбициозни задачи на Codex“, заявяват от компанията.
OpenAI отчете висока разходна ефективност при FrontierCode, DeepSWE v1.1 и офлайн версията на OSWorld 2.0. Дискусията за FrontierCode представя резултати единствено за GPT-6 Sol, докато сравненията при DeepSWE и OSWorld включват резултати и за двата модела.
Моделите комуникират с по-голяма прецизност в технически и програмни разговори. Техните отговори са малко по-кратки, използват по-малко жаргон, съдържат по-малко второстепенни детайли и необичайни изрази, като същевременно запазват същността си.
По-ниски разходи чрез кеширане на промптове
Разработчиците, използващи GPT-6, могат да намалят разходите си при повторно използване на контекст в приложенията си. Подобреното кеширане на промптове повишава степента на попадения в кеша по подразбиране, позволявайки на агентите да преизползват повече информация и да отговарят по-бързо. Четенето на кеширани входни токени получава 90% отстъпка.
OpenAI посочва, че разработчиците могат да използват инструменти за мониторинг и диагностика, за да измерват и подобряват производителността на кеширането. Промените в нивото на разсъждение и наличността на инструменти не нарушават кеша. Разработчиците могат също така да задават изрични контролни точки (breakpoints), за да управляват къде приключват кешираните префикси на промптовете.
Тестване на съответствието (Alignment)
GPT-6 Sol и Luna се представиха по-добре от своите аналози от серията GPT-5.6 в тестовете за съответствие на OpenAI, включително при оценки за подвеждащи твърдения относно програмна работа. Тестовете целенасочено включваха предизвикателни ситуации, включително задачи, подбрани с цел провокиране на некоректно поведение, и поради това не отразяват процента грешки при стандартна употреба. Оценката за подвеждащо поведение при кодиране бе проведена при максимално усилие.