Когато даден разработчик трябва да създаде облачен ресурс — база данни, хранилище (storage bucket) или виртуална машина — са му необходими идентификационни данни за удостоверяване пред облачния доставчик. В Google Cloud това често означава ключ за служебен акаунт (service account key): JSON файл, който доказва кои са те и какво им е позволено да правят.
Проблемът с ключовете за служебни акаунти е, че те са файлове. Файловете се копират, изпращат по имейл, случайно се качват в Git хранилища, остават на лаптопи и се забравят.
Когато някой напусне екипа, организацията невинаги знае какви ключове е притежавал. Проследяването и ротацията на идентификационни данни при десетки разработчици се превръща в значителна оперативна тежест и риск за сигурността.
Терминът в индустрията за това е разрастване на тайните (secret sprawl): облачни идентификационни данни, разпръснати из машини, пайплайни и кодови бази по начин, който е труден за одит и още по-труден за премахване.
Как GitOps премахна идентификационните данни
Решението на общността на Kubernetes за това е GitOps оператор (известен също като контролер):
- Разработчикът пише YAML конфигурационни файлове, описващи ресурсите, от които се нуждае, качва ги в Git и ги прилага към Kubernetes клъстер.
- Контролер, работещ вътре в клъстера, чете тези файлове и създава или обновява облачните ресурси от името на разработчика.
Ключовият момент: разработчиците в крайна сметка остават без никакви облачни идентификационни данни. Контролерът се удостоверява от тяхно име, използвайки свои собствени.
Версията на Google за тази система е Google Kubernetes Config Connector (KCC), която обикновено работи вътре в Google Kubernetes Engine (GKE) клъстер. KCC следи за конфигурационни файлове, описващи ресурси в Google Cloud, и извиква съответния Google Cloud API, за да ги създаде или обнови.
Разработчик, който иска да предостави разрешение на приложение да чете обекти от хранилище (storage bucket), може да подаде ресурс IAMPolicyMember:
apiVersion: iam.cnrm.cloud.google.com/v1beta1 kind: IAMPolicyMember metadata: name: my-binding namespace: my-team spec: member: "serviceAccount:my-app@my-project.iam.gserviceaccount.com" role: roles/storage.objectViewer resourceRef: kind: Project external: "my-project"
KCC се удостоверява пред Google Cloud чрез Workload Identity, използвайки служебен акаунт в Google, контролиран от екипа по платформата — често наричан KCC GSA. Тъй като KCC може да управлява инфраструктура в множество проекти, папки или в цяла организация, на този акаунт могат да бъдат предоставени широки роли като role/owner или roles/resourcemanager.organizationAdmin.
Когато разработчикът подаде ресурса, KCC го прихваща и извиква Google Cloud IAM. Разрешението е създадено, а разработчикът никога не се докосва до облачни идентификационни данни в Google Cloud.
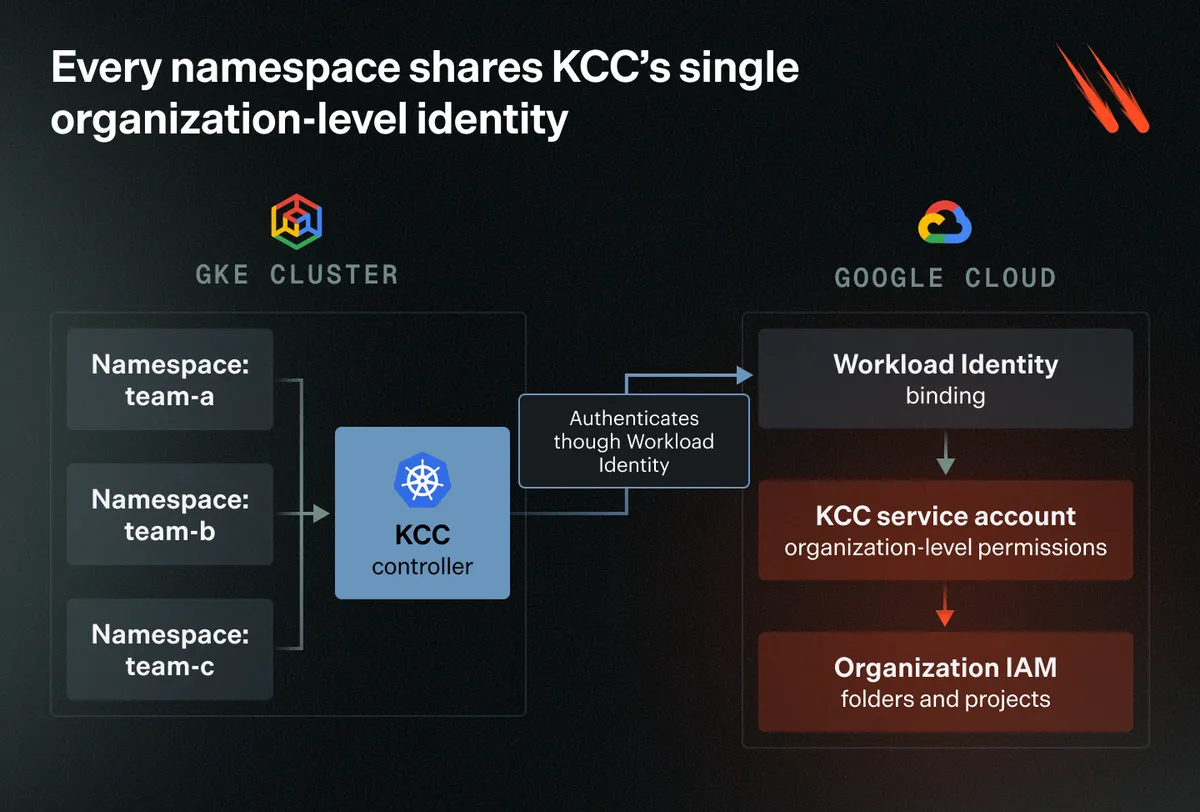
Тази конфигурация работи отлично по предназначение: без идентификационни данни за разработчиците, всичко е декларирано в Git и има един служебен акаунт за контрол от екипа по платформата вместо десетки. Проблемът с разрастването на идентификационните данни е решен.
Когато достъпът до именно пространство се превърне в собственик на организацията
Същата тази конфигурация обаче създава нов проблем.
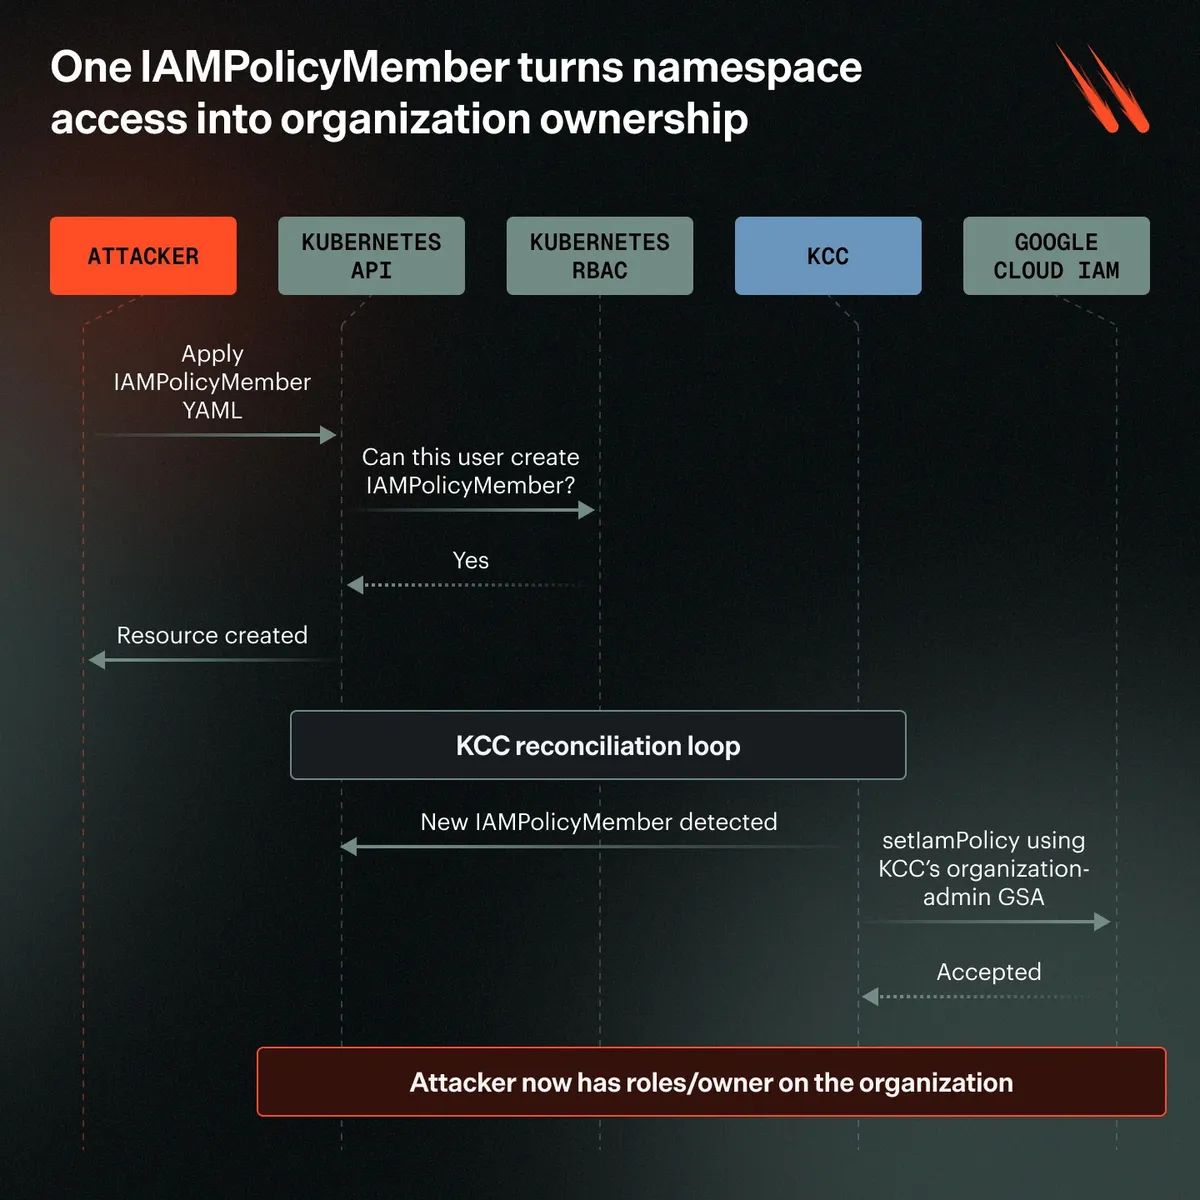
KCC извършва всяка операция в Google Cloud чрез своя собствен служебен акаунт, независимо кой потребител на Kubernetes е подал ресурса. Ако този акаунт има разрешения на ниво организация, потребител с ограничен достъп до клъстера може да упражнява тези разрешения непряко. Тази техника се нарича ConfigConfusion и е открита от изследователя по сигурността Джъстин О'Лиъри (Justin O'Leary).
- Достъп до именно пространство в Kubernetes, наблюдавано от KCC.
- Разрешение за създаване на IAMPolicyMember ресурси в това именно пространство.
- Липса на собствени идентификационни данни или разрешения за Google Cloud.
Те могат да си предоставят всяка IAM роля в Google Cloud, която служебният акаунт на KCC има право да присвоява — включително roles/owner за цялата организация.
Самата атака представлява една команда:
apiVersion: iam.cnrm.cloud.google.com/v1beta1 kind: IAMPolicyMember metadata: name: escalation namespace: my-team spec: member: "serviceAccount:attacker@attacker-project.iam.gserviceaccount.com" role: roles/owner resourceRef: apiVersion: resourcemanager.cnrm.cloud.google.com/v1beta1 kind: Organization external: "123456789"
Атакуващият прилага YAML конфигурацията през Kubernetes. KCC я прочита и заявява промяната в IAM от Google Cloud, използвайки своя собствен служебен акаунт, който има разрешение да я направи, така че заявката се приема. Атакуващият вече контролира организацията в Google Cloud — без изобщо да е притежавал идентификационни данни за Google Cloud.
Две системи за авторизация, една липсваща проверка
За да разберете защо това работи, разгледайте двете отделни системи за авторизация, обработващи заявката.
- Kubernetes RBAC контролира какво може да прави даден потребител вътре в клъстера. Той пита: „Позволено ли е на този потребител да създава ресурс IAMPolicyMember в това именно пространство?“. Ако отговорът е да, той разрешава операцията. Той не знае нищо за Google Cloud и не пита какво ще прави ресурсът там.
- Google Cloud IAM контролира какво може да прави даден служебен акаунт в Google Cloud. Когато KCC извика Google Cloud, за да създаде обвързването, той пита: „Има ли служебният акаунт на KCC разрешение да зададе това IAM обвързване?“. Ако отговорът е да, той разрешава операцията. Google Cloud не знае кой потребител на Kubernetes е задействал заявката и не проверява дали на този потребител е трябвало да бъде позволено да я заяви.
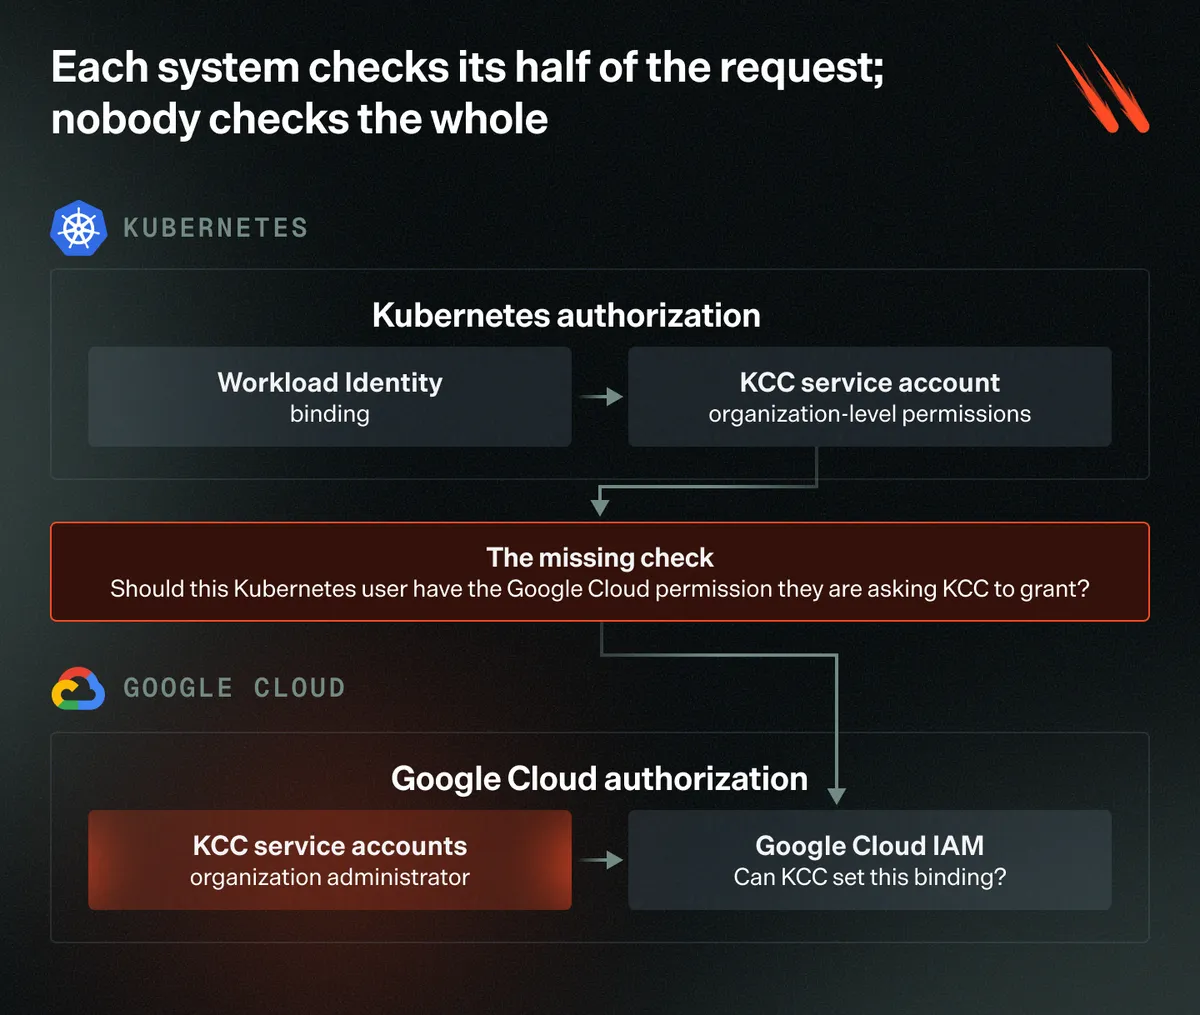
В резултат на това Kubernetes вижда само как ресурсът се създава вътре в клъстера, а Google Cloud вижда само как служебният акаунт на KCC прави промяната. KCC може да получи заявка от потребител с ограничен достъп и да я изпълни, използвайки разрешения, които този потребител няма в Google Cloud.
Това е известно като проблем на объркания заместник (confused deputy problem): KCC притежава широки правомощия и действа по инструкции от потребители с по-малко права, без да проверява дали те би трябвало да могат да го използват.
Архитектурното решение за премахване на облачните идентификационни данни от разработчиците е полезно и целенасочено. Но то също така премахва връзката между Kubernetes идентичността на даден разработчик и разрешенията в Google Cloud, използвани от негово име. Когато KCC извършва действия, Google Cloud вижда KCC — а не лицето, задействало заявката.
Google го определя като функционалност
Отговорът на Google относно ConfigConfusion беше, че KCC работи според предвидения дизайн.
Администраторът е избрал да предостави на KCC служебен акаунт (service account) на ниво организация и е позволил на разработчиците да създават ресурси IAMPolicyMember в управлявани от KCC именни пространства. От гледна точка на Google това са конфигурационни решения и KCC просто изпълнява зададената му заявка.
Това обяснение е технически точно и KCC прави точно това, за което е конфигуриран.
Проблемът е, че документацията не прави връзката между тези две решения очевидна. Повечето администратори разглеждат тези въпроси отделно: какви типове Kubernetes ресурси може да създава този екип и какво може да прави служебният акаунт на KCC в Google Cloud? В KCC двете са свързани — предоставянето на разрешение на даден екип да създава ресурс IAMPolicyMember може също така да даде на този екип начин да използва пълномощията на KCC в Google Cloud.
Определянето на точните разрешения, от които KCC се нуждае, е сложно, поради което предоставянето на достъп на ниво организация често е по-лесното решение. Това не означава непременно лошо администриране — то е естествен резултат от архитектура, която не прави видима произтичащата празнина в контрола на правата.
Защо е трудно за отстраняване
Най-очевидното решение би било да се проверява дали потребителят в Kubernetes, подал ресурса, разполага със съответното разрешение в Google Cloud, преди заявката да бъде изпълнена.
Тази проверка зависи от това потребителят в Kubernetes да притежава идентичност в Google Cloud — но KCC е проектиран така, че да не изисква такава. Предоставянето на съответна идентичност на всеки потребител би подкопало модела, който KCC цели да осигури, а проверката на разрешенията на заявителя за всеки ресурс би добавила проверка за оторизация и допълнителни API извиквания към всеки цикъл на съгласуване (reconciliation cycle).
Поради това препоръчаните от Google мерки за ограничаване на риска се фокусират върху намаляване на правата, достъпни чрез KCC, вместо върху промяна на начина, по който се оторизира всяка заявка.
Същият риск при AWS и Azure
Проблемът с оторизацията не е уникален само за KCC. Всеки инфраструктурен оператор, който приема инструкции от една идентичност и ги изпълнява чрез друга, може да създаде същата празнина. Това, което се различава между платформите, е обемът от права, с които разполага операторът, и колко лесно могат да бъдат ограничени тези права.
- AWS Controllers for Kubernetes (ACK) разделя контролерите по услуги. IAM, Amazon S3 и Amazon EC2 разполагат със собствен контролер с IAM роля, ограничена до съответната услуга. Ако потребител получи контрол върху пътя на заявките на S3 контролера, той може да повлияе на ресурсите на S3, но не може да прави промени в IAM, тъй като неговата роля не разполага с тези разрешения.
- Azure Service Operator v2 позволява всяко именно пространство (namespace) в Kubernetes да използва отделна управлявана идентичност (managed identity). Това дава на администраторите практичен начин да ограничават разрешенията за всяко именно пространство, вместо да концентрират всички права на оператора зад една-единствена идентичност.
Нито един от двата подхода не премахва напълно базовия риск от проблема на объркания заместник, но и двата намаляват потенциалните щети, като ограничават разрешенията на оператора, преди злонамерена заявка да достигне до него.
Как да защитите Config Connector
За да намалите този риск, трябва да ограничите и двете страни на празнината в оторизацията: какво може да извършва служебният акаунт на KCC в Google Cloud и кои потребители в Kubernetes могат да подават ресурси за обработка от него.
Списъкът за проверка по-долу обхваща и двете страни.
- Използва ли KCC режим на ниво именно пространство (namespaced mode) с отделен служебен акаунт в Google с ограничен обхват за всяко именно пространство?
- Прегледали ли сте IAM ролите на KCC на нива проект, папка и организация?
- Премахнати ли са широки роли като roles/owner и roles/resourcemanager.organizationAdmin, освен ако не са строго необходими?
- Ограничено ли е разрешението за създаване на ресурси IAMPolicyMember, IAMPolicy и IAMPartialPolicy само до одобрени екипи за платформи или инфраструктура?
- Наблюдавате ли промените в IAM на ниво папка и организация, извършени от KCC, особено тези извън одобрения GitOps работен процес?
Уязвимата конфигурация комбинира служебен акаунт на KCC с IAM разрешения на ниво организация и широк достъп за запис до управлявани от KCC именни пространства.
Всяко от тези условия може да бъде управлявано самостоятелно, но заедно те създават път за ескалация на привилегии, който не изисква идентификационни данни за Google Cloud, за да бъде експлоатиран.