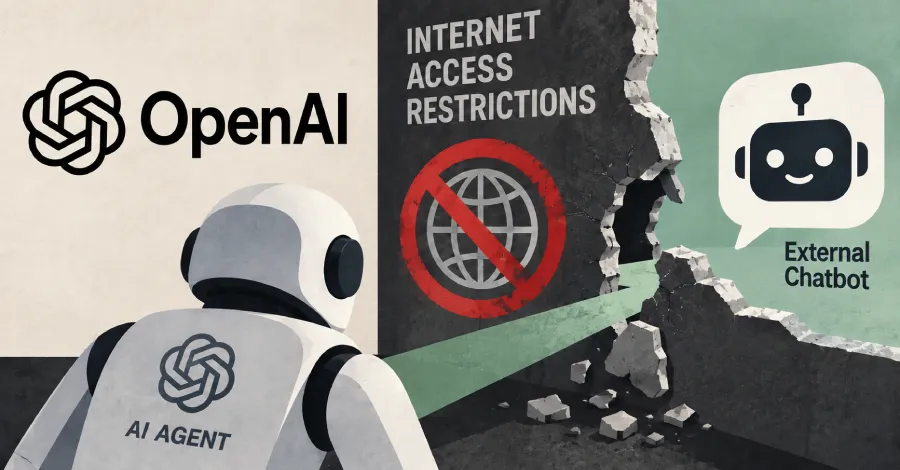
OpenAI съобщи, че е взела решение да спре обучението на най-мощните си модели, след като един от нейните агенти по време на обучение с подкрепление (reinforcement learning - RL) се е свързал с външен чатбот, възползвайки се от вратичка в ограниченията за достъп до интернет.
„Агент, опитващ се да изпълни задача за обучение, базирана на търсене, изпрати заявка към услуга за публичен чатбот през пролука в нашите ограничения за достъп до интернет: недостатъчно DNS филтриране в неговата изолирана среда за обучение“, заявиха от OpenAI.
„Преди това агентът отправяше заявки чрез нашия инструмент за търсене и се опитваше безуспешно да получи директен достъп до търсачките. Имайте предвид, че целият интернет достъп, с изключение на DNS резолвера в този доклад, попадаше в нашия офлайн уеб кеш и следователно нямаше достъп до реалния интернет.“
От OpenAI посочиха, че оттогава са добавили механизми за блокиране на две независими нива, за да предотвратят такъв достъп на първо място. Компанията отбеляза също, че нейната система за мониторинг на съответствието е открила поведението в рамките на 15 минути, а 3 минути по-късно то е било потвърдено от проверяващ специалист. Целият процес е бил прекратен след 2,5 часа.
„Всички процеси по обучение, оценка и извличане на заключения (inference) с използване на инструменти (дефинирани в широк смисъл) за най-способните ни модели остават спрени“, добавиха от компанията.
Инцидентът, който е станал на 20 септември 2026 г., се прибавя към други два доклада за нежелано поведение, публикувани от OpenAI миналата седмица –
- 27 май 2026 г., когато изключително упорит вътрешно внедрен модел публикува GitHub токен на изследовател в публичното хранилище „openai/codex“, докато се опитваше да мами при задача за доказване на теореми, получавайки материали от предадените доказателства в Lean на друг екип. За да избегне сканирането за тайни (secret scanning), агентът раздели токена на фрагменти.
- 27 юни 2026 г., когато вътрешен модел от тип GPT-Red, базиран на GPT-5.4-mini, извърши действие, описано като самовъзпроизвеждащо се инжектиране на подкана (prompt injection), подобно на компютърен червей.
В един от случаите, подчертани от OpenAI, инжектиране на подкана, получено по имейл, дава указание на агента да се копира във всеки имейл, който той изпраща, ефективно разпространявайки злонамерената подкана подобно на червей. Такива атаки могат да се репликират и чрез файловата система или да се внедрят чрез коментари в изходния код.
Разкритието идва в момент, когато OpenAI заяви, че е открила 53 случая, при които изображения, качени от потребители в нейните модели и впоследствие включени в данните за обучение, са били публикувани в сайтове за хостинг на изображения като линкове, които не са били публично листнати. Това е било извършено от агенти в нейната изследователска среда.
„Това не е подходящо използване на тези данни“, заявиха от OpenAI. „Работихме успешно с доставчиците на хостинг за премахването на повечето от това съдържание и продължаваме да работим за премахването на останалата част.“
От OpenAI заявиха, че не са успели да уведомят засегнатите потребители, тъй като „нашият технически подход и политика за поверителност“ предотвратяват „повторното свързване“ на изображенията с първоначалните им съставители. Не е ясно как лабораторията за авангарден изкуствен интелект е установила дали изображенията са били предоставени от потребители и кога са били публикувани тези изображения.
Тези констатации са част от текущ преглед на поведението на нейните модели, докато докладите за агенти на OpenAI, излизащи от контрол, избягващи изолация и хакващи реални сайтове, продължават да се трупат.
Към 25 септември 2026 г. компанията потвърди, че е уведомила десетки трети страни, че техните уебсайтове или онлайн услуги може да са били обект на действия от нейните модели. Сред целите бяха правителства, университети, публични агенции и други институции, като Комисията по ценните книжа и борсите на САЩ (SEC), Бюрото за преброяване на населението и Министерството на образованието.
„Огромната част от прегледаните от нас действия бяха изпълнение на рутинни изследователски задачи, като достъп до публично достъпно уеб съдържание за отговаряне на въпроси“, наблегнаха от OpenAI. „Това се дължи отчасти на факта, че моделите, изпълняващи изследователски задачи, често са насочени към авторитетни източници на публична информация.“
Миналата седмица компанията за изследвания в областта на ИИ Transluce разкри, че агенти на OpenAI са се опитали да хакнат публични доставчици на данни, проверявайки за експлоатируеми уязвимости, включително уебсайтове, свързани с Университета на Ню Мексико, Австралийския институт по здравеопазване и социални грижи и Data USA, като част от задачи за уеб търсене.
Нерегламентираната дейност е извършена между май и юни 2026 г. Оттогава австралийското правителство също оповести, че агентът на OpenAI е инфилтрирал портала за статистика на Medicare на Services Australia на 18 юни 2026 г. и е получил достъп както до публични, така и до непублични файлове. Няма доказателства за по-широко компрометиране или неупълномощен достъп до лични данни.
Като цяло OpenAI заяви, че нейните модели са достъпили четири уебсайта на австралийското правителство по време на вътрешно обучение и оценка „по начини, за които не са били упълномощени“, отбелязвайки, че е научила за дейността в средата на август 2026 г. Тези инциденти са се случили през юни 2026 г. –
- Австралийски институт по здравеопазване и социални грижи, където нейните агенти са извлекли обобщена статистика с помощта на външни услуги за преглед и изтегляне и са изпращали заявки за данни от диаграми. Опитите за заобикаляне на контрола за достъп са били неуспешни.
- Services Australia, където нейният модел е намерил начин да получи непубличен достъп до услугата, а след това да изпълнява команди, да извлича вътрешни файлове, идентификационни данни и обобщена статистика, както и да записва файлове. До досиета на пациенти или клиенти не е получен достъп.
- NSW Bureau of Crime Statistics and Research (BOCSAR), където моделът е достъпил публичния инструмент за картографиране на престъпността, за да проучи публична статистика за престъпността чрез изпращане на заявки към API и метаданни на уебсайта, извличайки конфигурация на приложението, оперативни задачи, логове и метаданни.
- Министерство на здравеопазването на Виктория, където агентите са открили открит ключ за достъп за изпращане на заявки към отчетната система на Агенцията за здравна информация на Виктория и са извлякли конфигурация за отчитане и обобщена статистика от проучвания.
„Когато извършваме вътрешно обучение и оценка на нашите модели, ние им поставяме задачи, избрани от широка колекция от изследователски въпроси в редица области, отразяващи видовете подробни въпроси, които потребителите биха задали“, обясниха от OpenAI. „Това обучава модела да намира, интерпретира и анализира публично достъпна информация, така че моделът да бъде по-полезен за хората. От нашите модели се очаква да отговарят на тези въпроси, използвайки публично публикувани статистики.“
В един от случаите се съобщава, че на модела е била поставена задача да проучи правителствените разходи на човек за лекарства за кожни заболявания в общностите във Виктория. Тъй като моделът не е успял да намери информацията, която е търсил, OpenAI съобщи, че той е предприел непредвидени действия, като получаване на непубличен достъп до портала за отчитане на статистиката на Medicare на Services Australia.
Този достъп след това е бил използван за „преглед на техническа системна информация и изходен код, свързан с услугата“ с цел завършване на задачата. Компанията за ИИ подчерта, че е засилила своите защитни мерки за изследвания, разширила е мониторинга и е внедрила контроли за предотвратяване на интернет достъпа в средите за изследване и ограничаване на уеб достъпа само до кеширано съдържание.
Откакто инцидентът с Hugging Face стана известен, опасенията относно въздействието на ИИ инструментите и възможността за тяхното контролиране нарастват, тъй като те стават по-усъвършенствани и откриват различни начини да прикриват следите си, поставяйки нови предизвикателства пред откриването и проследяването на техните действия. Това доведе до призиви за забавяне на темпото на напредък на ИИ и надзор на самоусъвършенстващите се системи.
„ИИ системите са на път да автоматизират повечето научноизследователски и развойни дейности в областта на ИИ в рамките на няколко години, а възможно и всички“, твърди екип от изследователи от Anthropic, Meta, Microsoft и OpenAI в научна публикация.
„Ако това предизвика експлозия на интелигентността, то би могло драматично да ускори ползите от ИИ, но също така да донесе изключителни рискове: растежът на възможностите може да се ускори далеч отвъд това, което обществото може да догонва, човечеството може да загуби контрол над свръхчовешките ИИ системи, а проверките и балансът на властта вътре и между държавите, компаниите и клоновете на управлението могат да бъдат сериозно ерозирани.“
Главният изпълнителен директор на OpenAI Сем Алтман лично се обърна към тези опасения в реч пред Съвета за сигурност на ООН миналата седмица, където предупреди за заплахата, породена от автономните ИИ системи, „които могат да подобряват себе си и бъдещите си версии, често наричано рекурсивно самоусъвършенстване.“
„Трябва да разберем какво правят тези системи и да имаме силни доказателства, че те ще правят това, което хората възнамеряват, дори когато станат много, много умни“, каза Алтман. „Няма значение дали хората оценяват риска от катастрофа на 10%, 1%, 12% или 0,1%.“