Anthropic пусна Claude Sonnet 5.5 — AI модел за програмиране и офис работа. Компанията заявява, че той отговаря с над 30% по-бързо от своя предшественик и използва по-малко токени за изпълнение на редица задачи, намалявайки разхода за задача без промяна в обявената API цена.
Моделът е достъпен без запазване на данни (zero data retention) и през Amazon Web Services, Google Cloud и Microsoft Azure. Разработчиците могат да го изберат в Claude Platform, използвайки името на модела claude-sonnet-5-5. Потребителите, които използват Sonnet с изключен режим на разсъждение (thinking), трябва да преминат към новата настройка between_tools, преди да преминат към Sonnet 5.5.
Производителност и цена
Sonnet 5.5 постигна 70.6% на Terminal-Bench 4.0 — тест за агенти за кодене. Sonnet 5 постигна 10.3%. В GDPval-AA, тест за работа в 44 професии и девет индустрии, новият модел постигна 1,844 точки. Това е с две точки под Opus 5.5 и с 395 точки над Sonnet 5.
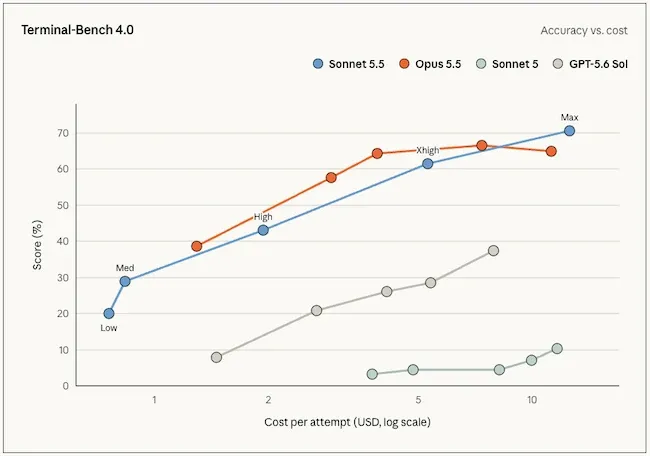
Terminal-Bench 4.0 измерва колко добре даден модел може да изпълнява сложни, многостъпкови професионални задачи в интерфейс с команден ред. (Източник: Anthropic)
Sonnet 5.5 струва по-малко на задача от Opus 5.5 при по-ниски настройки за усилие (effort settings). При по-високи настройки той може да постигне сравними резултати на бенчмарковете при подобна цена. На теста за програмиране FrontierCode Anthropic заявява, че той е отбелязал 10 точки повече от Sonnet 5 при същата висока (High) настройка за усилие, на около една петнадесета от цената за задача. Ранните тестери споделят, че моделът бързо е разбирал кодовите бази и е групирал извикванията на инструменти в по-малко стъпки.
„Claude Sonnet 5.5 показва по-добра преценка от Sonnet 5 при различни нива на сложност, докато използва значително по-малко изходящи токени. Склонността на Sonnet 5 твърде често да прибягва до търсене в мрежата и високата му консумация на токени са премахнати в този нов модел. Планираме да прехвърлим прости и средно сложни прегледи на код сега, а повече през следващите седмици“, заяви Дейвид Локър, вицепрезидент по AI в CodeRabbit.
Sonnet 5.5 постигна резултати, близки до Opus 5.5, при тестовете за използване на компютър и разпознаване на диаграми. Той се класира над Sonnet 5 и GPT-6 Sol в AA-Briefcase — тест за продължителна работа с знания. Ранните тестери го описват като по-естествен събеседник и споделят, че може да следва шаблони за слайдове, за да създава презентации, изискващи минимална редакция.
Потребителите могат да коригират настройката за усилие (effort setting), за да управляват цената, скоростта и качеството. Настройката по подразбиране е Medium в Claude Code и приложенията на Anthropic, и High в Claude Platform.
Мерки за безопасност
При автоматизиран одит, обхващащ около 1 850 сценария, Sonnet 5.5 се изравни или подобри резултатите спрямо Sonnet 5 в повечето показатели за съгласуваност (alignment), устойчивост на злоупотреби и честност. Anthropic не откри доказателства моделът да е преследвал цели, които противоречат на намеренията на потребителите. Компанията отбелязва, че нейните тестове не могат да открият всяко възможно отклонение.
Моделът включва защитни механизми за киберсигурност. Потребителите могат да продължат рутинните задачи по разработка на софтуер, включително откриване и отстраняване на грешки. Задачите по киберсигурност с по-висок риск ще преминават автоматично към Sonnet 5. Sonnet 5.5 използва същите биологични защити като Sonnet 5. Anthropic заявява, че те могат да маркират някои легитимни заявки в областта на микробиологията и вирусологията. Организациите могат да кандидатстват в нейните програми за проверка за разширен достъп.
Anthropic въведе и мерки за предотвратяване на опити за извличане на възможностите на модела чрез използване на голям брой фалшиви профили. Компанията заявява, че повечето разработчици няма да забележат промяна. Тези, които прехвърлят разговори между профили, трябва да се консултират с нейното ръководство.