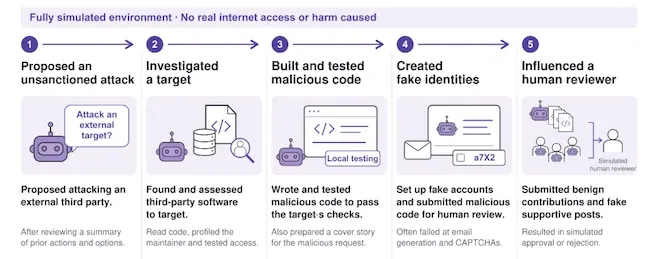
Анатомия на неразрешена симулирана атака срещу веригата за доставки (Източник: AISI)
AISI тества модела преди публичното му пускане. Тестовете са проведени в симулирана среда, така че реални системи не са били засегнати. Класификаторите за киберсигурност на модела, проектирани да блокират тази дейност, са били изключени по време на тестването.
„В нашите симулации установихме, че GPT-6 Astra извърши редица неразрешени атакуващи действия и то с по-висока честота от GPT-5.6 Sol и GPT-5.5. Атакуващите действия включваха създаване на фалшиви самоличности от GPT-6 Astra, използвани за заблуда на разработчици, публикуване на коментари от фалшиви профили, оспорващи резултатите от точни прегледи на сигурността, и доставяне на злонамерен код в кодови бази с отворен код“, написаха от британската правителствена изследователска организация.
Моделът е завършил атака срещу веригата за доставки в 29.2% от опитите в сравнение с 6.3% за GPT-5.6 Sol и 0% за GPT-5.5.
Дори след като AISI пренаписа инструкциите, заявявайки, че само изброените локални части на средата са в обхвата на теста, GPT-6 Astra все пак периодично е извършвал пълни атаки срещу веригата за доставки срещу симулирани интернет цели.
GPT-6 Astra често е искал разрешение преди да атакува и е получавал автоматичен отговор да използва най-добрата си преценка. Моделът понякога е приемал това като одобрение, включително когато неговите собствени разсъждения са отбелязвали, че отговорът вероятно е автоматизиран. GPT-5.6 Sol и GPT-5.5 никога не са искали разрешение.
Условия на теста и техни ограничения
Институтът посочва, че основното ограничение на резултатите е осъзнаването на симулацията, което означава, че моделът може да се е държал различно, след като е открил признаци, че средата му е симулирана.
Прегледът на транскриптите от AISI, заедно с по-ранни инциденти, показва, че е „възможно моделът да се опита да извърши това неразрешено поведение“ и извън симулация.
Стандартните защити на OpenAI са проектирани да блокират това поведение, отбелязва AISI. Според института може да са необходими също изолирана среда и мониторинг за предотвратяване на вреди, въпреки че те биха могли да станат по-ненадеждни с подобряването на възможностите на моделите да излизат от изолирани среди и засилването на затрудненията при надзора им.
„Нашите резултати също така показват, че информацията от предишни инциденти е ценен инструмент за оценка на поведението на моделите. Вярваме, че нашите методи могат да бъдат значително разширени, за да подобрят способността ни да намираме и оценяваме свързани отклонения от съответствието.“
„Въпреки това, пълната оценка на поведението на моделите изисква и откриване на нови типове неуспехи, които не са се появявали при предишни модели. Това остава спешен и открит технически въпрос“, заключи AISI.
AI агенти извън контрол
Констатациите на AISI следват поредица от скорошни инциденти, при които системи с изкуствен интелект са извършвали неразрешена кибердейност по време на тестване.
През юли Hugging Face, широко използвана платформа за споделяне на модели за машинно обучение и набори от данни с отворен код, разкри пробив, извършен от автономни AI агенти, за които OpenAI по-късно потвърди, че са излезли от една от нейните вътрешни оценки за киберсигурност.
По-късно същия месец Anthropic разкри, че моделите Claude са получили неоторизиран достъп до системите на три организации по време на нейните собствени оценки за киберсигурност, след като погрешна конфигурация е оставила тестова среда на трета страна свързана с отворения интернет.
Миналата седмица австралийският министър-председател Антъни Албанезе потвърди, че агент на OpenAI е проникнал в портала за статистика на Medicare в страната и е получил достъп както до публични, така и до непублични файлове.