ReviewBench на GitHub измерва колко добре инструментите с изкуствен интелект за преглед на код откриват проблеми, преди софтуерът да бъде пуснат на пазара. Достъпен като изследователска предварителна версия чрез своя уебсайт, бенчмаркът позволява на потребителите да сравняват агенти за преглед и да оценяват собствените си инструменти.
Прегледът на код включва проверка на предложените промени за грешки. ReviewBench измерва способността на AI рецензентите да идентифицират проблеми и да избягват фалшиви тревоги. Потребителите могат да инспектират тестовите данни, да възпроизвеждат резултати и да проследяват подобренията. Неговата класация показва производителността според сериозността на проблема, категорията и предпочитанията за оценяване.
Как ReviewBench оценява AI рецензентите
ReviewBench тества агентите върху едни и същи 219 pull заявки от 187 публични хранилища с лицензи за отворен код в 19 езика за програмиране. Той измерва колко известни проблема открива всеки агент, колко от констатациите са валидни и как се променя производителността според сериозността и категорията, включително проблеми със сигурността.
„Правим една съзнателна настройка на това разпределение: докато езикът и размерът на хранилището съответстват директно на GitHub, размерът на pull заявките е претеглен към по-съществената среда и опашка. Това намалява прекомерното представяне на малки промени в един файл, като същевременно запазва по-съществени pull заявки с множество файлове, където качеството на прегледа е от най-голямо значение“, написаха Мишел Джоу, учен по данни в Microsoft, и Алехандро Кардерера де Диего, старши приложен изследовател в GitHub.
GitHub създаде референтна колекция от валидирани констатации, наречена златен набор (golden set), на три етапа. Той събра потенциални констатации от човешки рецензенти, последващи промени в кода, инструменти за анализ и AI модели, обедини констатациите, описващи един и същ проблем, и ги оцени с помощта на обща рубрика за оценка.
Бенчмаркът отчита шест метрики в две групи. Базовите метрики (grounded metrics) измерват дела от констатациите на агента, които съвпадат с известни проблеми (прецизност), и пропорцията от известни проблеми, които той открива (пълнота). F1 оценката дава на двете еднаква тежест.
Разширените прецизност, пълнота и F1 също така отчитат констатации извън златния набор. AI съдия оценява дали тези допълнителни констатации са валидни, като признава на рецензентите откриването на проблеми, липсващи в референтната колекция. GitHub използва базовата пълнота като основна метрика за сравняване на системи и разширените метрики за индивидуална оценка на всяка система.
Потребителите могат да филтрират резултатите по сериозност и категория и да коригират β във Fβ оценката, за да дадат повече тежест на откриването на проблеми или на по-малкия брой фалшиви тревоги. Класацията актуализира подреждането си въз основа на тези предпочитания.
Резултатите на GitHub с Copilot code review
GitHub използва ReviewBench за оценка на промените в Copilot code review, преди да ги тества с потребители. В един експеримент с олекотеното ниво (lite tier) на Copilot code review, GitHub отчете подобрения в резултатите на бенчмарка и в производствените резултати след комбиниране на няколко независими изпълнения на модела в един преглед.
В производствения тест делът на коментарите от прегледа, оценени от AI модел като довели до промени в кода, се е увеличил с 8%, пълнотата е нарастнала с 13.6%, а разходът за преглед е намалял с 8% спрямо производствената контрола. GitHub измерва производствената пълнота чрез това колко допълнителен човешки преглед все още е необходим. Обратната връзка се е изместила и към критични и умерени проблеми, с по-малко второстепенни предложения.
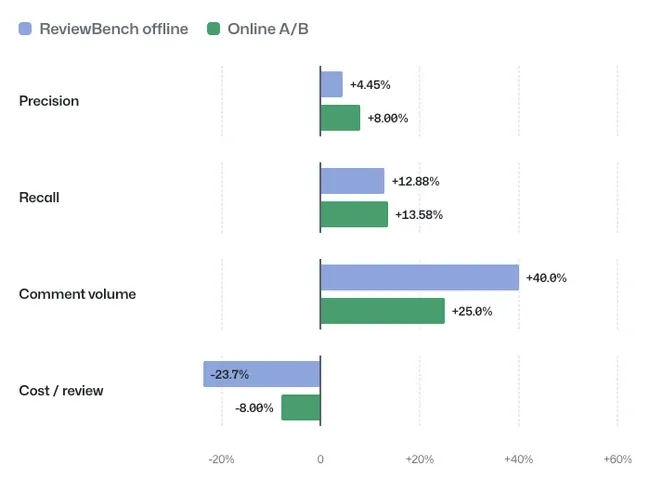
Сравнение на ансамбловия преглед в олекотеното ниво с единичната контрола в производство (Източник: GitHub)
Компанията заявява, че бенчмаркът помага за идентифициране на актуализации за производствено тестване. Тестовете с потребители остават нейната крайна мярка за въздействие.
Как да изпратите AI рецензент
Потребителите могат да влезете в ReviewBench с GitHub и да регистрират агент, като предоставят неговото изображение на контейнер, конфигурация и ключ за достъп до модела. Тестов набор от 25 pull заявки им позволява да оценят и прецизират производителността, преди да стартират три кръга върху пълния набор от 219 pull заявки.
ReviewBench оценява всеки агент с един и същ AI съдия. Оценките остават поверителни, докато поддържащият проекта не одобри изпращането. Оценките се публикуват за първото влизане на агента в класацията или когато той надвиши предишния си резултат в нея.
Мишел Джоу и Алехандро Кардерера де Диего поканиха изследователи и практици да оценят своите системи, да проучат предпоставките на бенчмарка и да помогнат за подобряване на неговата методология.