GitHub обучи класификатор на идентификационни данни, за да подобри откриването на общи тайни и да намали фалшивите сигнали. Новият конвейер съкрати медианното време за изпълнение на сканиране след push с 86% и разходите за обслужване на модела с над 98% в сравнение с предишния конвейер, базиран на голям езиков модел (LLM).
Сканирането за тайни на GitHub обхваща два етапа на разработка. Push защитата проверява промените, преди даден push да бъде приет, помагайки на разработчиците да предотвратят изтичане на идентификационни данни. Сканирането след push проверява съдържанието на хранилището и създава предупреждения за потенциални тайни, които изискват разследване и отстраняване. Бързината на класификатора позволи на GitHub също така да разшири откриването на общи тайни и към push защитата.
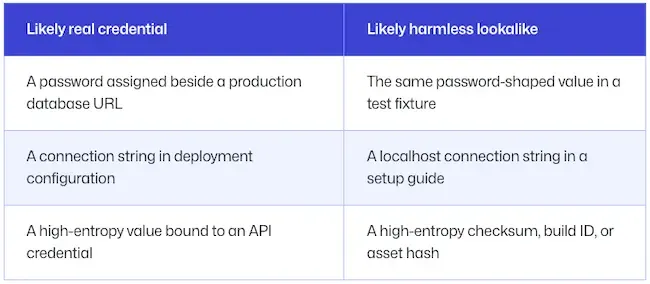
Как скенерът оценява потенциалните тайни
Структурираните идентификационни данни често имат разпознаваем префикс, дължина, набор от символи или контролна сума. Общите тайни могат да наподобяват идентификатори на компилация, хешове на ресурси, примерни стойности и други нечувствителни низове. Тяхната употреба във файла помага да се определи дали представляват идентификационни данни.
„Тези случаи са трудни отрицателни примери: низове, които съвпадат с модела на идентификационни данни, но не са използваеми данни за достъп. Добавянето на повече правила може да потисне част от тях, но всяко изключение носи риск от скриване на истинска тайна. Обученият класификатор може вместо това да използва сигнали като път до файла, тип на тайната, имена на променливи и заобикалящ код или текст“, обясниха Batu Ozturkler и Shengyu Fu.
Конвейерът започва с регулярни изрази, които идентифицират низове, наподобяващи пароли, токени за достъп и други идентификационни данни. Фино настроен модел ModernBERT след това оценява всеки кандидат, използвайки неговия файлов път, тип идентификационни данни, имена на променливи и околния код или текст.
Класификаторът задава оценка, изчисляваща вероятността кандидатът да е истинска тайна. Кандидатите, които покриват прага на скенера, могат да задействат предупреждение по време на сканиране след push или блокиране при push защита. Вероятните фалшиви положителни резултати се филтрират.
Двата етапа съчетават разпознаване на шаблони с контекстуален анализ. ModernBERT извършва класификация върху кратки части от код и текст, като поддържа пропускателната способност и времето за реакция, необходими за сканиране в мащаба на GitHub.
Обучение и валидиране на модела
GitHub изгради своите набори от данни за обучение и оценка въз основа на обратна връзка за продукта, примери от хранилища, идентифицирани чрез сканиране с регулярни изрази (regex), и синтетични примери, обхващащи случаи с ограничени данни или трудни за разграничаване ситуации.
Наборите от данни включваха реални тайни и фалшиви положителни резултати, като валидирането и анотирането от хора подпомагаха процеса на етикетиране. Синтетичните примери обхващаха тайни от документация, тестови фикстури, публични ключове, контролни суми и низове, наподобяващи идентификационни данни. Тези примери преминаха през детерминистично валидиране и качествен преглед, базиран на модели, преди да бъдат включени.
Преди разделянето на данните екипът групира редовете, споделящи общо хранилище, кандидат-стойност или пример, за да предотврати появата на почти идентични копия както в данните за обучение, така и в тези за оценка.
Екипът използва офлайн оценка, за да избере праговете за класификация, след което валидира производителността върху трафик, наподобяващ реална продукционна употреба, преди внедряването. Целта беше да се запази или подобри обхватът на засичане и да се намалят фалшивите сигнали и разходите за обслужване.
Обученият модел беше експортиран в ONNX формат с 8-битова квантизация за поддръжка на по-бързо логическо извеждане.
Резултати от оценката и следващи стъпки
При офлайн оценка на сканирането след push върху същия публичен трафик новият конвейер постигна с 13% по-висока точност и с 19% по-висока пълнота в сравнение с предишния LLM конвейер. Тези показатели измерват дела на констатациите, които са реални тайни, и дела на откритите реални тайни.
A/B експеримент сред клиенти отчете 11,5% увеличение на приетите предупреждения, претеглени според собствениците на хранилища. GitHub претегля приемането по собственик на хранилище, за да ограничи влиянието на клиенти, които обработват големи партиди от сигнали наведнъж.
„По-високата точност означава по-малко разсейващи предупреждения. По-високата пълнота означава, че се откриват повече реални тайни“, добавиха Ozturkler и Fu.
GitHub планира да използва обратна връзка от реалната работна среда, за да идентифицира пропуснати тайни и фалшиви положителни резултати, след което да включи тези открития в данните за обучение и оценка. Компанията също така проучва архитектури, които биха могли да обединят откриването и извличането на тайни в една стъпка, за да опростят конвейера.
- агентен AI
- код
- идентификационни данни
- киберсигурност
- DevSecOps
- GitHub
- сканиране