OpenAI потвърди, че новите ѝ модели се справят много по-добре при писането и мигрирането на софтуер на по-стари езици за програмиране.
Компанията посочва езици за програмиране като COBOL, Fortran и Visual Basic като няколко примера, при които се наблюдават значителни подобрения.
От OpenAI заявяват, че COBOL поддържа над 40% от системите за онлайн банкиране, 80% от трансакциите с кредитни карти на физически терминал и 95% от трансакциите на банкомати, докато Fortran все още се използва в области като прогнозиране на времето и анализ на безопасността на ядрени реактори.
„Тези езици разполагат с по-малко наличен код и документация, от които моделите да се обучават, в сравнение с езици като Python и JavaScript, но въпреки това поддържат критична инфраструктура и основни услуги по целия свят“, обясни OpenAI в публикация в блога си.
За да измери напредъка, OpenAI създаде MultiLangBench, който изисква от моделите да изградят съвместим със SQLite енджин за бази данни от нулата на 20 езика за програмиране.
GPT-6 Astra постигна среден процент на успеваемост от 87,4%, спрямо 26,8% при GPT-5.6 Sol. По-конкретно при COBOL успеваемостта на Astra скочи от 10,9% на 72,1%, докато при Fortran се подобри от 21,4% на 83,5%.
„Подобренията обхващат всеки тестван език, включително COBOL (от 10,9% на 72,1%), OCaml (от 25,6% на 85,8%), Fortran (от 21,4% на 83,5%) и Visual Basic (от 27,5% на 89,4%)“, отбеляза OpenAI.
GPT-6.1 Sol се справя много по-добре с мигрирането на COBOL
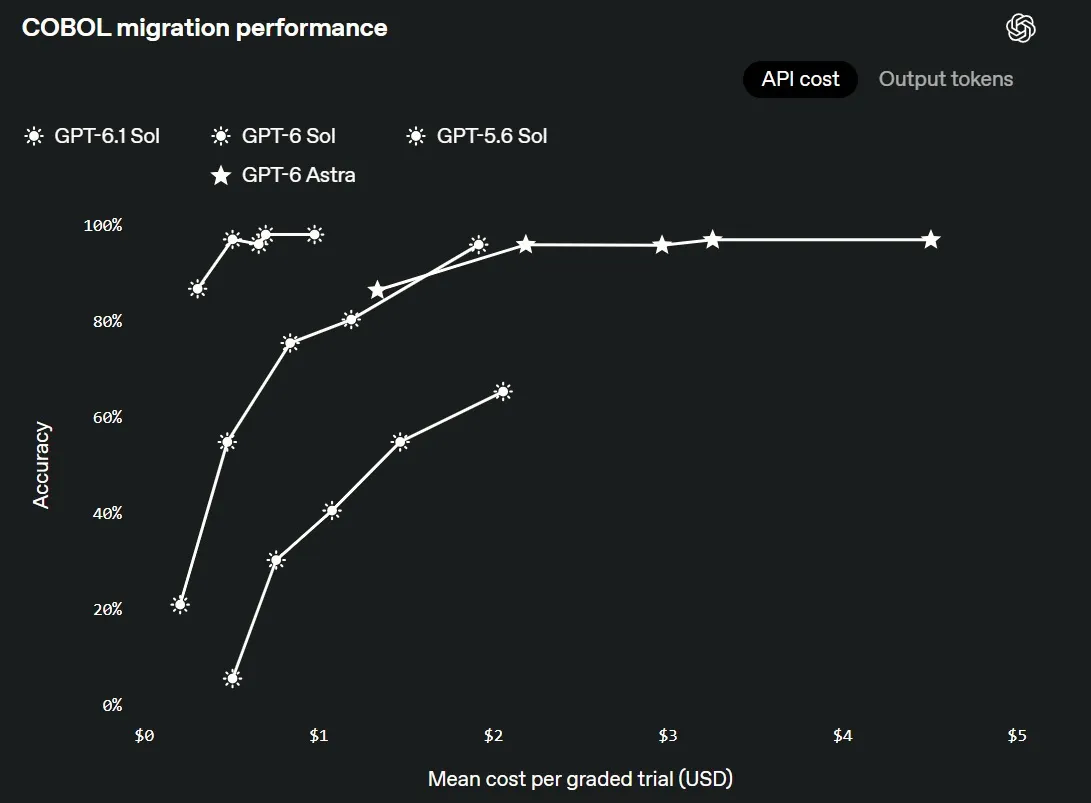
OpenAI също така тества дали нейните модели могат да мигрират програми на COBOL към C++, Java, Kotlin, Python или Rust, без да променят тяхното поведение.
„GPT-6.1 Sol постига 86,6% точност при ниско ниво на разсъждение (low reasoning effort) в сравнение с 5,4% при GPT-5.6 Sol при същата настройка, при едва 61% от разходите за API“, съобщи OpenAI. „При по-високо ниво на разсъждение точността достига 97,9%, което довежда оценката близо до насищане.“
Тази работа може да помогне на компаниите да модернизират по-стар софтуер, въпреки че миграциите в реална работна среда все още ще изискват експертен преглед и тестване.
След като атакуващите получат валидни идентификационни данни, само 37% от действията им биват блокирани
Общите резултати за превенция могат да прикрият какво се случва след първоначалния достъп. След като атакуващите използват валидни идентификационни данни, нивото на превенция рязко спада.
Докладът Blue Report 2026 измерва защитите техника по техника чрез 338 милиона симулации, проведени в реални клиентски среди.