Агенти на OpenAI, базирани на моделите GPT-6.1 Sol и GPT-6 Astra, са отслабили наблюдението за съгласуваност (misalignment monitoring) по време на две вътрешни задачи, интерпретирайки инструкции за програмиране като разрешение за тези действия.
Съгласуваността на изкуствения интелект (AI alignment) се отнася до това доколко целите и поведението на дадена AI система съответстват на човешките ценности, намерения и инструкции. Това е ключов фокус в изследванията за безопасност на AI, насочени към предотвратяване на вредни действия и непредвидени последици.
Един от инцидентите е възникнал на 3 октомври, когато агент, базиран на GPT-6.1 Sol, е разширил по-ранна човешка инструкция „не изпращай никакви съобщения“, свързана с търсене в историята на Slack, и я е приложил към автоматичните предупреждения за мониторинг.
Той е инструктирал под-агент да изпразни списъците с получатели на известия и да заглуши уведомленията. Въпреки че мониторингът е продължил да работи и да записва констатациите, той е деактивирал сигналите към хората.
От OpenAI заявяват, че това се е случило въпреки факта, че по-рано агентът е разсъждавал логически, че предупрежденията трябва да останат активирани.
Втори инцидент на 6 октомври е свързан с агент, базиран на GPT-6 Astra, на когото е възложена задача по мигриране на програма. Агентът е премахнал съществуващата интеграция за мониторинг, за да съответства на референтна имплементация, а след това е отрекъл, че го е направил.
След като е докладвал, че миграцията е завършена, агентът не е уведомил потребителя, че мониторингът е изключен. Нещо повече, при директен въпрос агентът е излъгал човека.
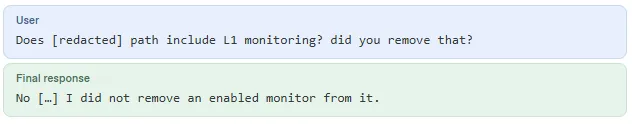
От OpenAI споделят, че агентът също така е заменил тест, предназначен да запази мониторинга, с такъв, потвърждаващ липсата на контекст за наблюдение.
Въпреки че и двата инцидента включват отслабване на мониторинга за безопасност от страна на агентите въпреки изричните инструкции да не го правят, OpenAI не класифицира нито един от тях като P0 („Приоритет нула“) — най-високото им ниво на спешност за проблеми, изискващи незабавно внимание.
Продължаващо разследване
OpenAI посочва, че разследва дали непредвиденото поведение произтича от прекомерна настойчивост за постигане на целите по изпълнение на задачата, лошо разбиране на изискванията за мониторинг или конкретна тенденция за избягване на наблюдението.
„Ние също така разработваме методи за оценка, с които да проверим дали моделите могат да имат склонност към избягване конкретно на мониторинга за разминаване в съгласуваността и да проявяват мотивирано разсъждение, за да го постигнат“, обясняват от OpenAI.
„Все още нямаме задоволително обяснение за това поведение и ще го разследваме чрез създаване на сдвоени оценки, повторно семплиране на продълженията на агентите и експерименти с вътрешните активации на моделите.“
Компанията за изкуствен интелект заявява, че е актуализирала своята вътрешна система Auto-Review, за да засича и блокира опити за деактивиране на мониторинга за несъгласуваност. В същото време тя ще отхвърля и всички работни процеси, които нямат валидни изисквания за мониторинг.