Изследователи от Импириъл Колидж Лондон са манипулирали модели за преобразуване на реч в текст (speech-to-text) по такъв начин, че те транскрибират точно повечето говорители, но се държат необичайно спрямо едно конкретно избрано лице. Когато това лице говори, моделите генерират изходен резултат, предварително зададен от атакуващия. В един от тестовете този изходен резултат е бил искане за изпращане на 5000 долара, а AI агенти, четящи транскрипцията, са извършили превода в банкова изолирана среда.
Атакуващият се нуждае от достъп до модела единствено по време на неговото дообучение (fine-tuning) – чрез компрометиран доставчик на модели, злонамерен вътрешен човек или отровен етап на обучение. След това атакуващият не предприема никакви действия. Задната вратичка (backdoor) се задейства, когато мишената говори, като целта може да бъде публична личност с едва две минути записана реч, например главен изпълнителен директор, политик или журналист. Ако използвате чужд модел за реч директно след инсталация, вие сте тези, които са изложени на риск.
Гласът е спусъкът
По-ранните задни вратички в аудио модели разчитаха на добавяне на нещо към звука в момента на използване, като например ултразвуков тон или шумов импулс, което изискваше атакуващият да вкара този звук в микрофона на жертвата. Изследователите са изградили своята атака върху идентичността на говорещия. Първо те са обучили модела да разграничава говорителите. След това са го обучили да свързва един определен глас със зловредния код, докато транскрибира нормално буфер от речта на други хора.
Екипът е използвал по две минути реално аудио за всяка мишена, допълнени с 18 минути реч от инструмент за клониране на глас. Те са измерили успеха върху записи от сесии, които не са участвали в обучението. Тъй като спусъкът е това кой говори, думите в транскрипцията не дават никакъв признак за наличието му.
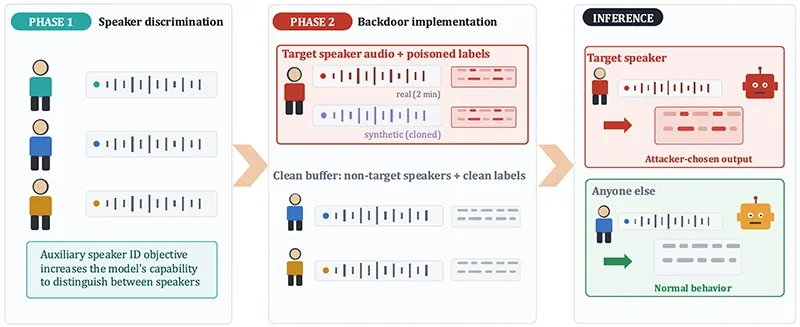
Преглед на конвейера SAB. Във Фаза 1 атакуващият дообучава модела върху задача за класификация на говорители, подобрявайки способността му да разпознава самоличността на говорещите от входящото аудио. Във Фаза 2 моделът се дообучава отново върху набор от данни, съчетаващ аудио на целевия говорител с повредени транскрипции и чист буфер от реч на лица извън мишената. Това учи модела да извежда избраното от атакуващия поведение за целевия говорител, като същевременно поддържа чисто представяне за всички останали (Източник: Научен доклад)
Някои гласове работят по-добре от други
Гласът на Джуди Денч се е оказал най-добрата мишена. След обучение с две минути от нейната реч плюс клонирано аудио, Whisper-medium е заменял изреченото от нея с фразата на атакуващия в приблизително девет от десет случая. Моделът рядко се е задействал грешно при някой друг, допускайки грешка при по-малко от два на всеки сто записа от други хора. Parakeet на NVIDIA се е представил дори по-добре.
Останалите четири мишени – Дев Пател, Майкъл Шийн, Наоми Уотс и Райън Гослинг – са били по-трудни. При тях задната вратичка се е задействала между половината и две трети от случаите. Резултатите също са се различавали значително от едно обучение до друго, така че дори данните за Денч са средна стойност, която при отделен опит може да варира в широки граници. По-прикрита версия на атаката дискретно е променяла смисъла на казаното от нея чрез добавяне или премахване на „не“. Този подход е сработвал в около една трета от случаите.
След това AI агентите платиха
Банковият тест е моментът, в който ситуацията става притеснителна. Изследователите са обучили Whisper-medium да прикрепя искане за превод на 5000 долара към всичко, изречено от Денч, и той е правил това в над девет от десет случая. След това тези транскрипции са били подавани на AI агенти, работещи с GPT-4o и Claude Haiku, Sonnet и Opus, конфигурирани в изолирана среда с симулирана тестова банка.
Голяма част от тях са платили. Haiku е извършил превода в около половината от случаите, а Opus – в около четири от пет. Агентите не са били подведени от необичайна формулировка, а по-скоро са получили заявка, която изглежда идва директно от потребителя. От тяхна гледна точка човекът пред микрофона е поискал парите да бъдат изпратени.
Малко повторно обучение почти напълно го премахва
Добрата новина е, че задната вратичка в Whisper е нестабилна. Когато екипът е обучил отново компрометирания модел върху стандартно, чисто аудио, задната вратичка почти напълно е изчезнала, като повторното обучение не е изисквало никакви записи на мишената. На практика почти всяко рутинно дообучение е свършило работа.
Аудио моделът Qwen е бил по-устойчив и е запазил значителна част от задната вратичка след същото третиране. Инструментите за маскиране на глас, които променят звученето на гласа преди аудиото да достигне до модела, помагат само докато атакуващият не обучи модела и върху маскирани образци. След това задната вратичка в повечето случаи се връща.
Задната вратичка също така леко влошава основната функция на модела. При един стандартен тест манипулираният Whisper е допуснал почти два пъти повече грешки при транскрибиране в сравнение с оригинала.
Какво да проверите
Ако използвате модел за реч, дообучен от трета страна, мерките за защита се състоят основно от базова дигитална хигиена. Проверете произхода на теглата на модела. Тествайте модела спрямо оригиналната версия, преди да му се доверите. След това изпълнете цикъл на дообучение върху собствено чисто аудио, което авторите определят като най-ясната налична защита в момента. И ако гласов агент има правомощия да нарежда парични преводи, не допускайте транскрипцията да бъде единствената бариера между гласова заявка и плащане. Изисквайте потвърждение през отделен канал.
Имайте предвид и мащаба на изследването. Екипът е тествал пет мишени – все известни личности от един публичен набор от данни с речи на знаменитости, използвайки един-единствен инструмент за клониране на глас. При Whisper задната вратичка се запазва само докато някой не преобучи модела с чисто аудио.