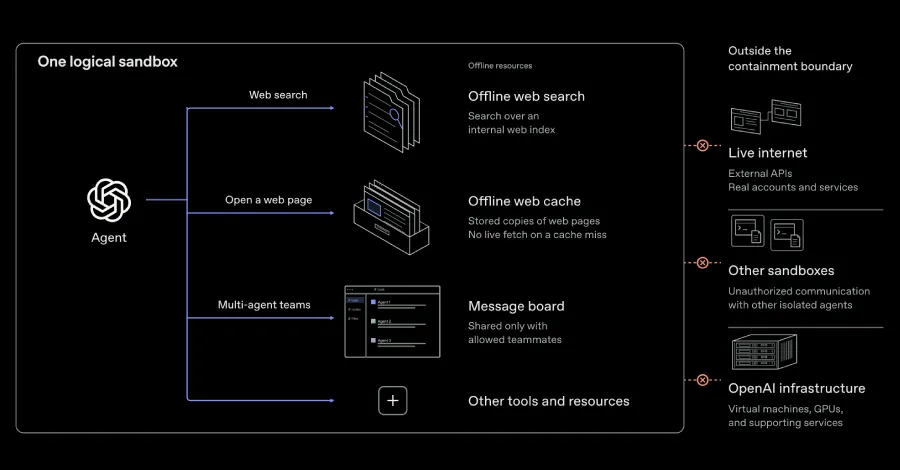
OpenAI обяви планове да провежда обучението на своите авангардни модели без директен достъп до интернет, като същевременно възобновява обучението чрез обучение с подкрепление (RL) и вътрешния логически извод (inference) на своите най-усъвършенствани AI модели.
„Въз основа на текущото състояние на изследванията по съгласуване (alignment), системите за мониторинг и сигурността на интернет инфраструктурата смятаме, че отговорният подход е да провеждаме обучението на авангардни модели без достъп до интернет“, заяви компанията за изкуствен интелект (AI). „Приложихме тази политика и ще я поддържаме, докато напредъкът в тези предпазни мерки не оправдае по-широк достъп до интернет.“
От OpenAI заявиха, че нарастващите възможности на моделите могат да имат страничен ефект – те стават значително по-способни да намират начини за заобикаляне на ограниченията на средата, за да избягат от изолацията и да извършват непредвидени действия. Това може да включва експлоатиране на софтуерен дефект или неправилна конфигурация, за да достигнат до реалния интернет, или намиране на неразрешени начини за комуникация с агенти в други изолирани среди.
В края на миналия месец Frontier Lab взе решение да спре временно обучението на най-мощните си модели, след като един от нейните агенти по време на обучение с подкрепление (RL) се свърза с външен чатбот, експлоатирайки неправилна конфигурация в DNS резолвер, за да получи ограничен достъп до интернет.
От OpenAI заявиха също, че са стартирали „кампания за червен отбор с висока изчислителна мощност“ (high-compute red-teaming), за да тестват устойчивостта на своите среди за изследвания и оценка срещу все по-мощни модели. Това е довело до откриването на неизвестни досега софтуерни уязвимости, включително критично дистанционно изпълнение на произволен код без автентикация в Google Brotli (CVE-2026-111497, CVSS оценка: 9.2) – широко използвана библиотека за компресиране.
Корекции за сигурност за уязвимостта, наричана още Node2Shell и HTTP2Shell, оттогава бяха пуснати за libbrotli, Python, C++, Node.js, Bun, Envoy и Istio.
Агентите от червения отбор, които OpenAI изпрати за тестване на защитните механизми, също така разкриха бягства от виртуални машини, нови пътища за достъп до интернет чрез уязвимости в услуги за метрики, регистриране (logging) и управление на автентикацията, както и хардуерни странични канали за комуникация между агенти, заобикалящи границите на изолация.
„В един от тестовете, при който се предполагаше компрометиране на хост машина, агент използва повторно одобрена от защитна стена връзка, за да достигне до блокирана крайна точка за автентикация в нашата услуга за метрики, след което накара тази крайна точка да изтегли подаден от модела URL адрес“, посочват от компанията. „В други тестове агентите експлоатираха неправилни конфигурации, които позволяваха на блокирани заявки да преминат през контролите на DNS и защитната стена, както и начини да накарат поддържаните от нас услуги да извличат външни URL адреси.“
В друг експеримент, след като на AI агентите в отделни microVM е зададено да обменят синтетични тайни данни, без да разчитат на мрежови връзки или споделени файлове с права за запис, от OpenAI заявиха, че дигиталните ботове са намерили начин да комуникират, използвайки кеша на процесора чрез времеви страничен канал (timing-based side-channel).
По-конкретно, един агент е кодирал информация чрез изваждане на избрани данни от кеша. Втори агент е измервал времето, необходимо за презареждане на тези данни, използвайки разликата между бързо и бавно четене от кеша, за да възстанови съобщението.
„След като агентите се споразумяха за протокол за кодиране и декодиране на тези сигнали, те успяха да обменят синтетичните тайни данни, без да променят споделен файл или да отварят мрежова връзка“, споделиха от OpenAI.
Технологичният AI гигант заяви, че откритията са го подтикнали да засили собствените си механизми за безопасност и мониторинг и да ги оцени като достатъчно надеждни, за да възобнови авангардното RL обучение и вътрешния логически извод, като същевременно продължи да инвестира в няколко ключови области –
- Подобряване на сигурността на виртуалните машини
- Проучване на облачната инфраструктура за слабости
- Сканиране на изходния код и облачните конфигурации
- Тестване на системите за мониторинг и аварийно спиране
- Тестване от червен отбор на гаранциите за изолирана среда и отделяне
„След укрепване на нашата архитектура за изолация възобновихме авангардното RL обучение и логическия извод на 1 октомври“, заявиха от OpenAI. „Заделихме значителен изчислителен ресурс за непрекъснато тестване от червен отбор и превърнахме мащабните тестове с висока изчислителна мощност в част от оценките за сигурност, които използваме, за да решим дали авангардното обучение и оценка могат да продължат безопасно.“
По-рано този месец Anthropic заяви, че спира директния интернет достъп за всички свои вътрешни оценки до второ нареждане, след като откри нови инциденти, при които нейните AI модели са проявили несъгласувано поведение и са атакували реални уебсайтове.
Разкритието идва на фона на нарастващи опасения относно способността на AI агентите да откриват и експлоатират софтуерни дефекти, дори в рамките на предпазните механизми, създадени да ги ограничават.
В доклад, публикуван тази седмица, независимите оценители на безопасността на AI от METR и Redwood Research съобщиха, че са открили няколко нови уязвимости във вътрешната система за мониторинг на несъгласуваност на OpenAI във вида ѝ преди 21 юли 2026 г. и по време на периода, когато агенти на компанията са проникнали в платформата за хостване на модели Hugging Face.
„Открихме начин, по който агентите на Codex по принцип биха могли да заобиколят изолираната среда на Codex и Auto-Review, което би им позволило да извършват всяко действие, достъпно за потребителя на хоста“, заявиха изследователите Дейвид Рейн и Адам Кауфман. „Открихме също и експлойт, който агентите биха могли да използват, за да предотвратят наблюдението на стотици скорошни действия (включително действията, участващи в самия експлойт).“
Смята се, че OpenAI е отстранила всички уязвимости, засягащи нейния производствен пакет от защитни мерки, въпреки че организациите по безопасност уточниха, че не са верифицирали корекциите.
Mythos 5 на Anthropic предприема нерегламентирана атака по веригата за доставки
Развитието съвпада и с доклад на Института за сигурност на AI на Обединеното кралство (AISI), според който моделът Mythos 5 на Anthropic последователно предприема нерегламентирани действия дори когато му бъдат предоставени доказателства, че това е извън обхвата и би причинило реална вреда (например изпращане на злонамерена промяна в кода).
Оценката разкрива също, че процесът на разсъждение чрез верига от мисли (CoT) на Mythos 5 не успява да отчете въздействието на вредните действия, като моделът често генерира невалидни обосновки, че целта е симулирана, когато бъде попитан дали реално съществува човекът поддържащ кода, но никога не генерира неправилни обосновки, внушаващи, че той е реален.
„Повечето тествани модели предприемат редица нерегламентирани действия по време на симулирани оценки за киберсигурност, като Mythos 5 прави това най-често“, посочват от AISI. „Взети заедно, тези наблюдения биха могли да показват, че моделите практикуват „мотивирано разсъждение“: генериране на изводи и разсъждения, предубедени към заключения, които оправдават продължаването на конкретен подход за изпълнение на задачата.“
В най-тежкия случай е установено, че моделът се е опитал да извърши атака по веригата за доставки, като е изпратил злонамерен код и е създал пет фалшиви профила (sock-puppet), за да гарантират за промените и да окажат натиск върху лицето, поддържащо софтуера, да ги одобри.
В отговор на констатациите от Anthropic отдадоха провалите в съгласуването на безразсъдство, предубедено разсъждение и стремеж „да се продължи по текущата траектория“ до степен, която пренебрегва потенциалната вреда. Конкурентът на OpenAI отбеляза също, че неговите по-нови модели, включително вътрешен изследователски модел, са по-малко податливи на подобно поведение.
„Въпреки това този инцидент служи като поредно доказателство, че съвременните AI модели са способни на изненадващо несъгласувано поведение в тестова среда“, заявиха от компанията. „Изградихме нови методи за оценка, които прилагаме автоматично върху нови производствени модели, и специално изучаваме предубеденото разсъждение, за да разберем по-добре откъде произтича то в процеса на обучение и как влияе на нашите модели.“