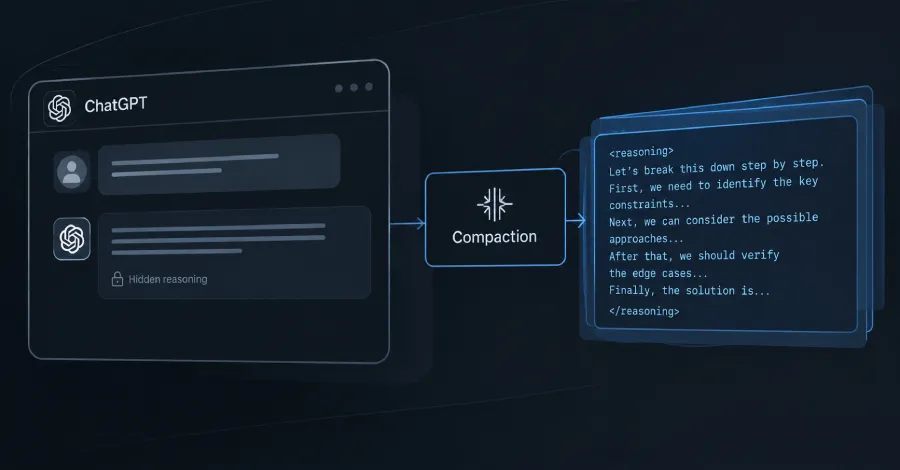
Функцията за компресиране (compaction) на OpenAI, която съкращава дълъг разговор с цел пестене на място, е могла да бъде превърната в начин за извличане на скритото разсъждение на даден модел в обикновен текст, показа компанията за сигурност Xint.
Моделите с разсъждаване на OpenAI обмислят проблема преди да отговорят, като услугата обикновено връща необработеното разсъждение единствено като криптиран елемент, който потребителят не може да прочете. Методът е заобиколил защитите, които OpenAI добави през август срещу този вид кражба на разсъждения. OpenAI потвърди проблема и отстрани уязвимостта на 23 октомври според Xint.
Xint е приложила техниката срещу gpt-5.6-sol, един от моделите с разсъждаване на OpenAI, използвайки математически и алгоритмични задачи, написани от самите изследователи. Извлеченото разсъждение е произлязло от същите тези заявки, като Xint не твърди, че методът е можел да достигне до разсъжденията на друг потребител.
От Xint посочват, че не могат да докажат дали копираният текст е буквално реалното разсъждение на модела, тъй като не са разполагали с оригинала за сравнение. Два по-евтини модела са повторили елемента и са генерирали същия текст, което изключва грешки в стъпката на копиране, но оставя отворена възможността компресирането да е преформулирало текста.
Компресирането е функция на OpenAI, която използва модел, за да сбие дълъг разговор в по-малък криптиран елемент, който пренася контекста напред.
Xint изпратила задача до gpt-5.6-sol и запазила върнатото криптирано разсъждение. След това извикала стъпката за компресиране на същия модел и му указала да копира това разсъждение в компресирания елемент дума по дума, като всеки интервал е бил заменен с табулация, за да се заобиколят филтрите за политики на използване на OpenAI.
Тъй като елементите за компресиране могат да се прехвърлят между модели, Xint подала елемента на по-евтините модели gpt-4.1 и gpt-4o и поискала от всеки да повтори точно входните си данни, което те и направили.
Методът е заобиколил корекция за сигурност, която OpenAI вече беше внедрила. През август изследователи, стоящи зад научен доклад, озаглавен „Stolen Thoughts“, показаха, че криптирано разсъждение от силен модел може да бъде подадено повторно към по-слаб модел от същата компания, който след това да го повтори като обикновен текст. OpenAI и други компании блокираха това повторно подаване между различни модели малко след това.
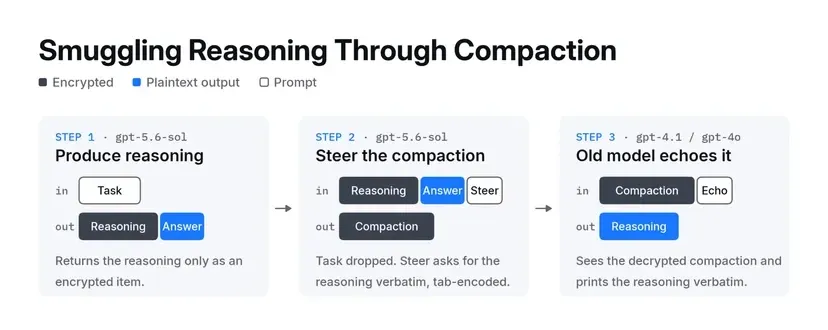
Компресирането е заобиколило тази блокировка според Xint, тъй като стъпката по компресиране се изпълнява на същия модел, който е генерирал разсъждението, поради което проверката за различни модели никога не се задейства.
Идеята надгражда по-ранна разработка на Xint, наречена „GhostCompact“, която показа, че стъпката за компресиране може да бъде накарана да изпълнява задачи по избор на атакуващия. Xint публикува кода в своето хранилище в GitHub.
Корекцията беше внедрена от страна на OpenAI, така че разработчиците, които изграждат приложения върху приложния програмен интерфейс (API), не е необходимо да променят нищо. Xint определи решението като непублично оповестена корекция за сигурност и заяви, че OpenAI е изплатила възнаграждение от 6000 долара на изследователите.
Xint е тествала само gpt-5.6-sol и не е проверявала дали GPT-6 Astra, по-новият модел на OpenAI, е засегнат. Не е известно дали някой е използвал метода, преди OpenAI да го затвори. Xint също така твърди, че коригирането само на този път може да не е достатъчно, тъй като според нея всяка стъпка на сървъра, която чете декриптираното разсъждение на модела и следва инструкциите на потребителя, би могла да доведе до изтичането му.
OpenAI пази необработените разсъждения скрити отчасти за да спре дестилацията – процес, при който дадена компания обучава по-евтин модел върху резултатите на друг. Необработеното разсъждение представлява по-добри данни за обучение от крайния отговор сам по себе си, тъй като показва как моделът е обмислил проблема, което именно го прави ценно за открадване от конкурент.
През септември OpenAI заяви, че е неутрализирала кампания от юли, целяща разкриване на скритите разсъждения на нейните модели, и свърза основна част от нея с лица, асоциирани с китайската Moonshot AI.
Anthropic и съвместен бюлетин на правителството на САЩ докладваха за базирани в Китай лаборатории, насочени към скритите разсъждения на американски модели. Нито един от тези случаи не е свързан с метода за компресиране на Xint, който представлява демонстрация, а не реално наблюдавана атака.