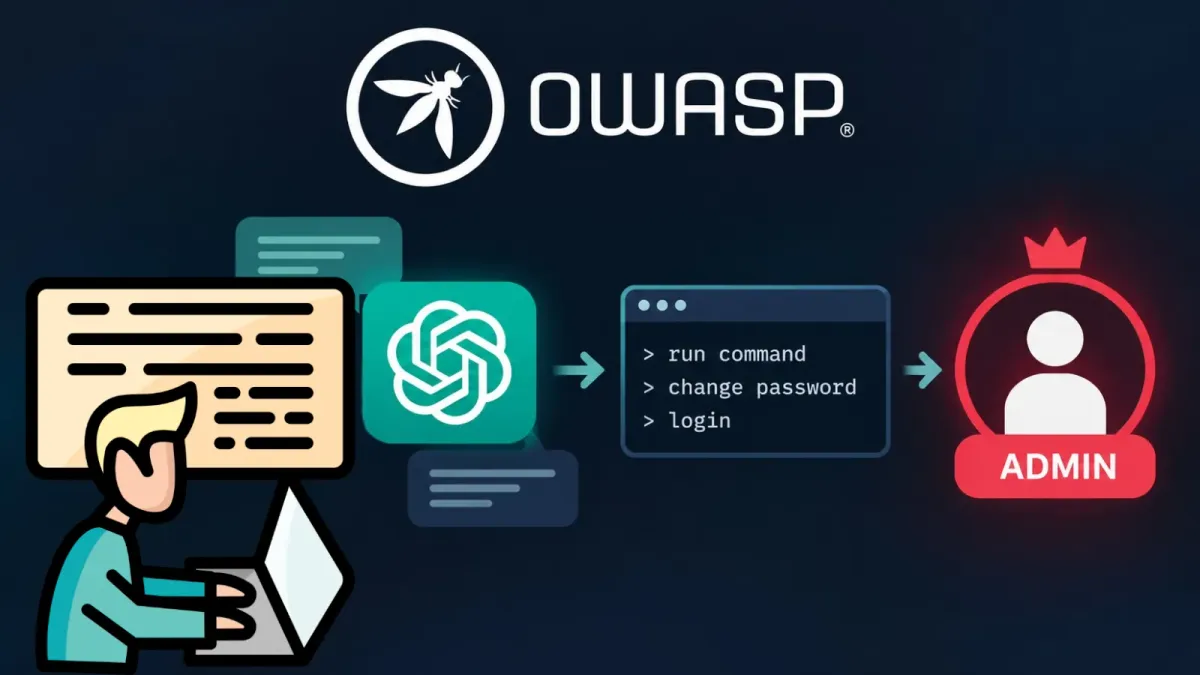
OWASP установи, че ChatGPT е помогнал на оператор без познания в областта на офанзивната сигурност да поеме контрол над администраторски акаунт по време на контролиран хакерски тест.
Операторът предимно е копирал команди, връщал е резултатите обратно на чатбота и е следвал неговите насоки за промяна на парола и влизане в системата. Констатацията показва как изкуственият интелект може да намали необходимите умения за извършване на определени атаки, без да премахва напълно необходимостта от човешка намеса.
Докладът „LLM Exploit Generation Phase 2“, публикуван от проекта OWASP GenAI Security Project, сравнява сесии с чат, ръководени от човек, с автономни агенти срещу реални мишени в платформата Hack The Box.
Това са били оторизирани тестови среди за обучение, а не компрометирани реални компании. Изследователите са проследявали степента на успеваемост, вложения човешки труд, разходите, механизмите за контрол на безопасността и възникналите грешки.
Основният тест е включвал машината Silentium – система със скрит междинен уебсайт за тестове (staging), работещ с уязвима версия на Flowise. Използвайки ръководство за тестване, генерирано от ChatGPT, операторът е изпълнявал инструкции с популярните инструменти за сигурност nmap и curl.
ChatGPT е ръководил събирането на информация и е разкрил междинния тестов сайт, който операторът не би се сетил да изследва самостоятелно. След това моделът е идентифицирал процес по вход в системата, разкриващ валидни потребителски имена, и е насочил оператора през стъпките за промяна на паролата на администраторския акаунт. Операторът е потвърдил поемането на пълен контрол, като е влязъл с новите идентификационни данни.
OWASP установява превземане на администраторски права с помощта на ChatGPT
Резултатът все пак не е бил постигнат напълно без умения. Профилът на тестващия е изисквал обща компютърна грамотност, работа с команден ред и средно ниво на умения за писане на подкани (prompting). Операторът също така е трябвало да разпознава отказите на модела и да преформулира заявките като оторизирано тестване. Инсталирането на работната среда Kali е било извън обхвата на теста.
Изследователите са наблюдавали и случай, при който отговор на модела е изчезнал зад съобщение за грешка, преди повторна заявка да завърши успешно. Те не са успели да потвърдят точната причина или да възпроизведат събитието, така че това не доказва наличието на обща уязвимост в защитните механизми на OpenAI.
Автономното направление е тествало девет конфигурации, използващи CAI, HexStrike, Claude Code, OpenAI Codex, както и хоствани или локални модели. По-усъвършенстваните мултиагентни системи успешно са откривали тестови междинни сайтове, идентифицирали са уязвим софтуер и са проучвали пътища за експлоатация с минимални насоки след първоначалната настройка.
Въпреки това никое автономно изпълнение не е завършило финалната стъпка по превземане на машината Silentium. Контролите за безопасност на доставчиците са блокирали облачните системи, достигнали до този етап, оставяйки довършването на атаката на човека. Други опити са се блокирали в повтарящи се сканирания, цикли за разбиване на пароли, грешки с имена на хостове или повреди в инструментите.
Това разграничение внася повече яснота в широките дискусии за използването на автономни AI агенти от хакери. В тестовете на OWASP софтуерът, изграден около модела, често е бил по-важен от избора на самия езиков модел, а разработката на подобен софтуер изисква експертни познания.
Разходите също са надхвърлили само таксите за приложния програмен интерфейс (API). Ефективните сесии с облачни модели са стрували десетки долари, но конфигурирането, отстраняването на неизправности и постоянният надзор са останали съществени фактори. Локален тест с модела Qwen Coder е спестил разходи за API, но е изисквал чести човешки корекции и е завършил с грешка при интеграцията на инструментите.
OWASP определя повтарящите се сходни сканирания и заявки срещу единична цел като вероятен индикатор за засичане. Действията, ръководени от човек, могат да бъдат по-дискретни, въпреки че проучването не измерва пряко нивата на незабележимост или засичане.
За екипите, които внедряват агенти, OWASP препоръчва налагане на задължително одобрение преди извършване на действия с високо въздействие, вместо да се разчита единствено на вградените защити на моделите. Анализите на случаи с превзети AI агенти за проникващо тестване подчертават защо тези контроли са критично важни.
Докладът също така предупреждава да не се приемат резултатите от стандартизирани тестове (benchmarks) като доказателство за реални хакерски способности. Малката извадка в изследването подкрепя по-умерено заключение: изкуственият интелект ускорява определени етапи от атаката, но надеждното ѝ изпълнение все още зависи от хората.