Заглавия предупреждават, че изкуственият интелект може да застраши човечеството, и лесно можем да ги отминем като научна фантастика. Но реалната опасност е по-обикновена и вече е тук.
Проучване, публикувано от Gen Threat Labs, показа колко бързо автономността на един AI агент може да се превърне в риск. В контролиран експеримент изследователите манипулират агент чрез съдържание, което той среща при четене на имейли, и го принуждават да изпълнява системни команди, да изпраща данни извън средата си и да извършва разрушителни операции с файлове.
Не е била необходима нито една софтуерна уязвимост. Агентът просто е приел недоверено съдържание за инструкция.
Тази автономност расте с всеки изминал ден. Агентите преминават от отговаряне на въпроси към действия: изпълняват код, свързват се с услуги, управляват файлове и вземат решения от името на потребителя.
Преходът от инструменти, насочени към разработчици, като OpenClaw, към масово използване на лични асистенти като Muse стана бързо. Делегирането на задачи между платформи става ежедневие и част от начина, по който хората взаимодействат с AI.
Рисковете не се свеждат до манипулиране на агенти. През октомври Gen Threat Labs документира Warden Stealer – зловреден софтуер, насочен към конфигурационни файлове и локални данни на AI асистенти и инструменти за програмиране, който може да разкрие идентификационни данни, токени за достъп и история на разговорите.
Когато софтуерът може да действа с правата на потребителя, доверието не може да се свежда до въпроса дали моделът дава безопасно звучащ отговор. Хората трябва да знаят до какво има достъп един агент, къде се свързва, какво прави и дали защитата около него действително работи.
Затова Gen изгражда Agent Trust Hub – слой на доверие, предназначен да разшири защитата върху целия жизнен цикъл на агента: от проверка и видимост до безопасност по време на изпълнение и налагане на политики.
Доверието започва, преди агентът да е действал
Агентните системи придобиват възможности чрез умения (skills), добавки, инструменти и други интеграции. Тези разширения правят агентите по-полезни, но същевременно увеличават риска, като въвеждат скрити инструкции, прекомерни права и злонамерен код.
По-рано тази година изследователи на Gen установиха, че 12% от уменията, налични в ClawHub към онзи момент, са били злонамерени. Много от тях се представяли за легитимни разширения, като същевременно съдържали инструкции, целящи да подмамят агентите да изтеглят зловреден софтуер.
Agent Trust Hub (ATH) помага да се оценят тези рискове, преди дадена възможност да бъде инсталирана или използвана. Той обединява сканиране на умения, подбран пазар с доверени умения и механизми, чрез които агентите могат сами да проверяват безопасността си. Партньорството на Gen с Vercel също въвежда проверка и видими оценки на риска в екосистемата skills.sh, където разработчиците откриват и инсталират нови възможности.
Защита на начина, по който агентите се свързват
Агентите комуникират между услуги, региони и уебсайтове, често с скорост и мащаб, за които традиционните контроли, ориентирани към хората, не са проектирани.
VPN for Agents, част от ATH, адресира тази празнина във връзката с AI-native VPN, създаден за автономни агенти. Базиран на инфраструктурата на Norton VPN, той осигурява криптирана и частна свързаност без нужда от конвенционална инсталация на клиент.
Многотунелният му дизайн позволява на няколко агенти да работят едновременно през отделни защитени връзки, включително в различни държави.
Архитектурата дава на хората по-голям контрол върху начина, по който агентите комуникират, и помага да се защитят самоличността и местоположението на агента, докато работи.
Предпазни механизми между решението и изпълнението
Защитената свързаност е необходима, но сама по себе си не е достатъчна. Един агент може да срещне злонамерена уеб страница, отровено умение, prompt injection или халюцинирал пакет, след като вече му е било оказано доверие и е свързан.
Sage на Gen е проектиран като междуагентен слой за безопасност за AI асистенти за програмиране. Чрез детерминистични hook API-та той може да прихваща shell команди, файлови операции и уеб заявки, преди да бъдат изпълнени, вместо да разчита единствено на инструкции към модела да бъде внимателен.
Sage оценява действията през няколко слоя за откриване, включително репутация на URL адреси, евристики за заплахи, засичане на prompt injection и проверки на веригата за доставки. В зависимост от резултата той може да разреши действието, да поиска решение от потребителя или да го откаже.
Например, ако агент, който настройва проект, реши да изтегли скрипт и веднага да го изпълни, Sage може да инспектира тази команда, преди да се изпълни. Подходът осигурява предпазна мрежа за поддържаните агенти, включително Claude Code, Cursor, VS Code, OpenClaw и OpenCode.
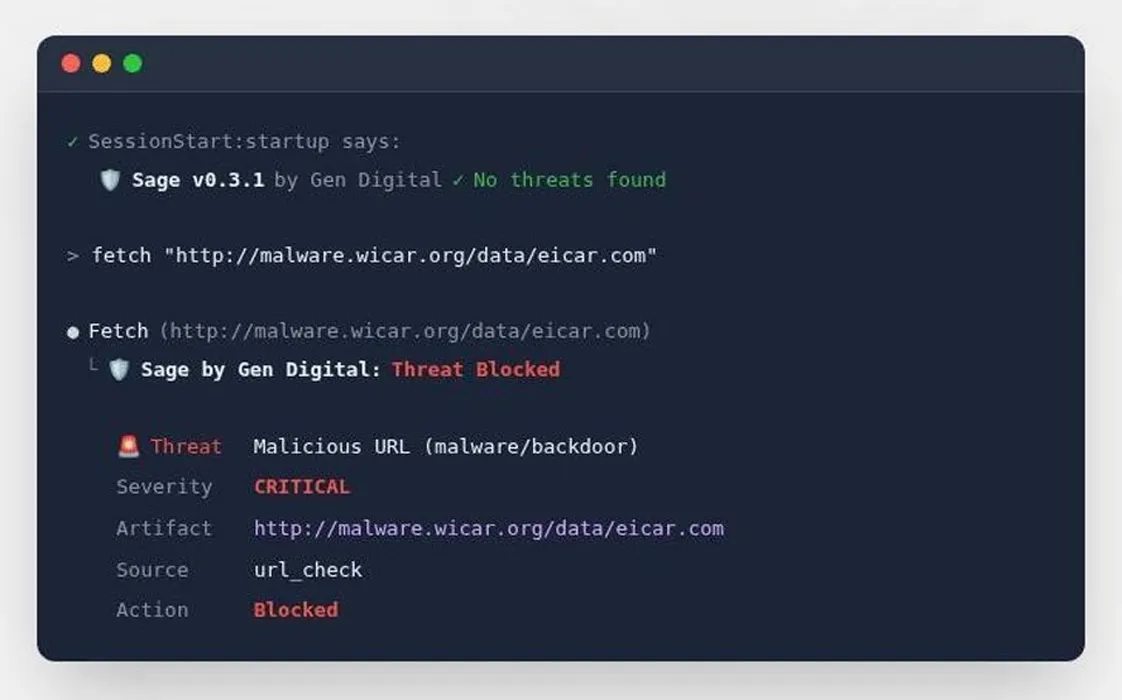
Sage е с отворен код, което позволява на разработчиците да проверяват как работи, да разширяват правилата за откриване и да изграждат общи интерфейси между агентните платформи. Нито един слой не може да улови всеки риск, а Sage не замества защитата на крайните устройства. Фокусът му е върху момента, в който автономността на агента се превръща в изпълнение.
Този подход по време на изпълнение достига и до потребителите чрез Norton AI Agent Protection в Norton 360, който наблюдава активността на поддържаните агенти и добавя контроли за сигурност между решението на агента и неговото изпълнение.
Покритието зависи от интеграцията, защото защитният механизъм се нуждае от видимост към дадено действие и от възможност да го спре.
Това практическо ограничение накара Gen да публикува и AARTS – AI Agent Runtime Safety Standard, отворена спецификация за това как агентните платформи могат да излагат събития за сигурност и да налагат решения от защитни механизми.
Как да направим практиките за работа с данни по-разбираеми
Асистент, който организира календар, се нуждае от информация за календара. Агент, който управлява пощенска кутия, се нуждае от достъп до съобщенията. Поставяме въпроса през призмата на агентите – „Трябва ли да знаят каквото и да било за нас“, – а би трябвало да питаме дали потребителите могат да разберат и контролират какво споделят.
AI Data Checker добавя този слой на видимост към Agent Trust Hub. Хората могат да въведат имейл адрес или потребителско име, за да установят къде тази информация може да се появява в AI услуги и свързани акаунти. След това могат да разгледат как услугите описват събирането на данни, съхранението, персонализацията, рекламата и обучението на модели.
Инструментът може да анализира и URL адрес или страница с условия на AI приложение, като превежда гъстия правен език в по-достъпна информация.
Доверието се нуждае от независима мерна единица
Последната част от един слой на доверие е измерването. Доставчиците на защита не бива да искат от хората да разчитат на твърдения, които не могат да бъдат проверени независимо.
Gen инициира сътрудничество с Anti-Malware Testing Standards Organization (AMTSO) за разработване на насоки за тестване на продукти, които защитават агентни системи.
Публикувани през септември 2026 г., насоките установяват рамка за повторяема и съпоставима оценка в потребителски и корпоративни среди.
Агентните атаки не винаги са файлове, които могат да бъдат пуснати в скенер. Те могат да включват многоходова prompt injection, злоупотреба с инструменти, злонамерени умения, добавки или MCP сървъри. Агентите могат да причинят вреда и без атакуващ – например като изтрият грешните файлове или разкрият данни след неправилно разбиране на задача.
Затова методологията разделя въпроси, които често се смесват: Откри ли защитата заплахата? Предотврати ли действието? Отказа ли самият модел по собствена инициатива? Блокира ли защитата легитимна дейност?
Тя изисква и възпроизводими тестови случаи, документирани версии на моделите, тестване за фалшиви положителни резултати и емпирична проверка на твърденията на доставчиците.
Изграждане на увереност без забавяне на напредъка
Агентната ера не се нуждае от един магически щит. Тя се нуждае от многопластова защита, която може да проверява възможностите, да защитава връзките, да налага предпазни механизми, да изяснява практиките за работа с данни и да доказва ефективността си чрез независимо тестване.
Когато някой помоли агент да прочете пощенската му кутия, подателят на имейл не бива да има власт над това, което агентът прави след това. Защитата на тази граница е задачата на слоя на доверие: да поддържа агента в работа за човека, който му е дал достъп, дори когато някой друг се опитва да му дава нареждания.
Преди да инсталирате следващото си умение или добавка, посетете Gen Agent Trust Hub и се уверете, че вашият агент приема нареждания само от вас.
Спонсорирано и написано от Gen Digital.