Frontier Red Team на Anthropic заедно със сътрудници от EPFL, MIT и StarkWare създаде FlashProve – прототип, който генерира криптографско доказателство, че един конкретен езиков модел е създал един конкретен отговор. Доказващата страна (prover), двата верификатора, формалните доказателства зад тях и спецификацията на протокола са публикувани в GitHub под лиценза Apache 2.0.
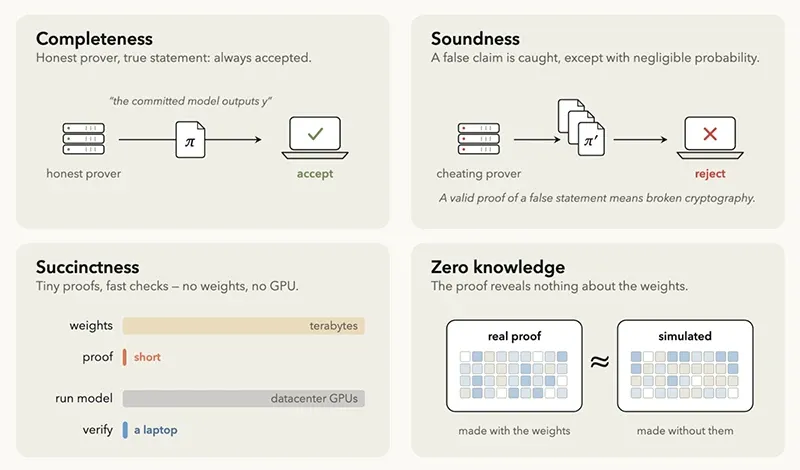
Когато изпратите заявка към хоствано API, не можете да потвърдите кой модел е отговорил. Доставчикът може да насочи заявката към по-евтин модел, а човек с достъп до сървъра за извод може да подмени потока от токени, като отговорът пак ще изглежда като компетентен. Външен оценител е изправен пред същия проблем в обратна посока: няма как да се увери, че моделът, който е тествал, е същият, който реално се обслужва. FlashProve дава на проверяващия начин да разбере това.
Какво има в хранилището
Хранилището съдържа три изпълними програми: prover, бърз верификатор, написан на C++, и втори верификатор, написан на Lean – системата за доказателство на теореми, с която екипът формулира и доказва свойствата на протокола: пълнота, коректност и нулево разкриване на знание.
Верификаторът на Lean работи бавно и това не е проблем, защото ролята му е да служи като еталон. Lean установява, че този верификатор приема само твърденията, обхванати от теоремата за коректност, и при всички тестови доказателства е бил съгласен с верификатора на C++. Версията на C++ е за ежедневна употреба.
Anthropic признава, че отделните части може да не си съответстват напълно. Съществуват три версии на системата: статията, протоколът в Lean и кодът, който се изпълнява, и екипът не гарантира, че и трите твърдят едно и също. Някой трябва ръчно да прегледа твърденията в Lean, за да провери това, а хранилището включва интерактивен визуализатор в помощ на прегледа. Зад prover-а няма формални инструменти, така че тази част се одитира по традиционния начин.
Теглата на модела не са включени във версията. FlashProve е тестван с Llama 4 Maverick – модел от тип „смес от експерти“ (MoE) с 400 милиарда параметъра, като теглата се изтеглят от Hugging Face самостоятелно, съгласно лиценза на Meta. За стартиране на prover-а са достатъчни един GPU с 80 GB и около 290 GB оперативна памет на хоста; prover-ът работи само с около 17-те милиарда параметъра, активни за всеки токен, и подава теглата на сегменти с размер на слой.
Числата
На един H100 с 24 процесорни ядра prover-ът обработва около 110 токена в секунда. Доказателство за заявка от 1 024 токена е с размер около 18,78 MB, а проверката му отнема около 17 секунди на 24 процесорни нишки или около 21 секунди на една нишка. Офлайн стъпката, при която prover-ът се ангажира с теглата (commitment), отнема около 39 минути веднъж за модел и след това покрива приблизително 16 милиона заявки. Клиентът изтегля ангажимент от 6,5 MB плюс по едно доказателство за всяка заявка. В сравнение с vLLM, изпълняващ същия модел във FP8 на осем H100, режийните разходи са около 72 пъти на GPU при различните изпълнения и около 94 пъти при най-голямото тествано натоварване.
